
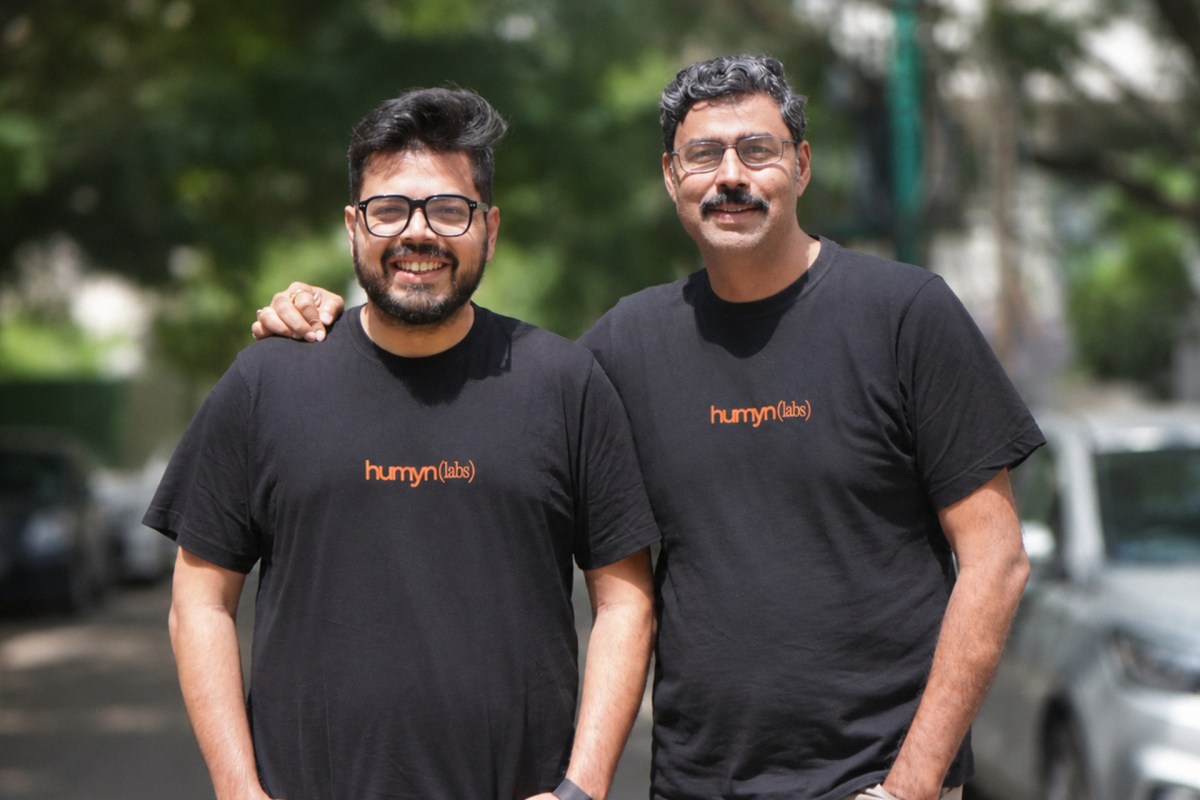
编者按:当大模型把「数据饥渴」推到极致,机器人行业正成为新的数据黑洞。印度初创公司Humyn Labs拿到4700万美元融资,做的事本质上是把人类动作翻译成机器人能学习的养料——而它的客户,几乎全部集中在美国。
据TechCrunch报道,总部位于印度的初创公司Humyn Labs已完成4700万美元融资。这家今年2月才成立的公司,主营业务是为机器人企业提供训练所需的真实世界数据。值得注意的是,其约90%的收入来自美国客户——这意味着在具身智能最活跃的市场里,一家印度公司已经找到了自己的位置。
一、机器人行业的数据荒
大语言模型的成功建立在互联网海量文本之上,但机器人面临的是完全不同的困境:物理世界没有「现成语料」。机械臂如何稳稳抓起一只形状不规则的杯子、人形机器人如何在堆满杂物的房间里不摔倒、灵巧手如何在力道与触感之间取得平衡——这些能力很难靠爬取网页习得。
目前业内的主流路径包括遥操作示教、动作捕捉、第一视角视频采集,以及在仿真环境中生成合成数据。但仿真与现实之间存在难以弥合的差距(即所谓 sim-to-real gap),真正能让机器人「学会」的,仍然是大量来自真实场景的高质量动作数据。这类数据采集成本高、周期长、标准化程度低,供给远跟不上需求。
二、Humyn Labs在卖什么
Humyn Labs切中的正是这个缺口。从公司对外披露的定位看,它并非自研机器人本体,而是作为「数据供应商」,向机器人厂商交付可用于训练基础模型的动作与感知数据。这是一种典型的「卖铲人」生意:淘金者成败未知,卖铲子的先收到钱。
这个模式的吸引力在于,它把原本分散、非标准化的数据采集工作工业化——通过招募并培训采集人员、搭建统一的操作流程与硬件套件、建立数据质检与标注体系,把「人类怎么做事」转化成结构化、可复用、可规模化的训练资产。
三、为什么是印度,为什么是美国
地理上的分工并非偶然。一方面,印度拥有庞大且年轻的劳动力池,英语沟通成本低,人力成本显著低于欧美,这让需要大量人工作业的数据采集与标注业务具备天然的成本优势;另一方面,印度与美国存在约10至13小时的时差,理论上可以形成「美国下需求、印度连夜交付」的接力式协作。
而美国,则是当下全球机器人创业密度与付费能力最强的市场。从人形机器人明星公司到仓储物流自动化厂商,再到自动驾驶与工业机械臂企业,都在争抢有限的高质量真实数据。约90%收入来自美国,既说明Humyn Labs的产品契合了最挑剔客户的需求,也暴露出其收入结构的高度集中。
四、赛道正在变拥挤
Humyn Labs并非孤军。TechCrunch提到,它的竞争对手包括Mecka AI与XDOF等初创公司。更宏观地看,这条赛道的玩家还可以分为几类:一类是传统的AI数据标注巨头,正在从文本、图像向多模态与机器人数据延伸;一类是机器人公司内部的数据团队,倾向于自建采集能力;还有一类是依托高校与实验室的项目型团队。
竞争的关键,短期内是交付速度与价格,长期看则是数据质量、场景覆盖度与标准化能力。谁能定义「什么样的数据才真正提升机器人的泛化能力」,谁就有机会成为行业的事实标准。
五、4700万美元买的是什么
这笔融资的规模,对于一家成立不到一年的公司而言并不算小。它至少说明两件事:其一,资本仍然愿意为具身智能的上游基础设施下注;其二,投资者相信数据供给会成为制约机器人落地的瓶颈之一。
但挑战同样清晰。首先是客户集中度风险,过度依赖单一区域市场意味着地缘政治、汇率与贸易政策波动都可能直接冲击营收;其次是垂直整合风险,一旦大客户决定自建数据管线,供应商的议价能力将被削弱;第三是数据的可商品化程度,如果采集流程足够标准化,后来者复制门槛会迅速降低,毛利率可能被持续压缩。
六、结语:卖水人的黄金时代还能持续多久
回顾过去两年,AI产业链的价值分配反复上演同一个剧本:先是一拥而上的模型公司,随后是提供算力的芯片厂商,最后是提供数据与工具的基础设施玩家。机器人行业很可能重演这一路径——在机器人真正走进工厂与家庭之前,为它们「喂数据」的公司会先一步尝到甜头。
对Humyn Labs而言,4700万美元是弹药,也是压力。它需要在窗口期内把人力密集的采集业务,升级为技术驱动的数据引擎;否则,当行业标准成型、客户开始自建能力时,「卖水人」的护城河或许并没有想象中那么深。
本文编译自TechCrunch。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接