
MLPerf Inference每一轮结果都是行业工程投入的实时快照。v6.1在两方面尤为突出:提交者数量创历史新高,同时清晰显示行业正向agentic与端到端基准测试转型,并伴随大量新型硬件涌现。
提交者与提交规模
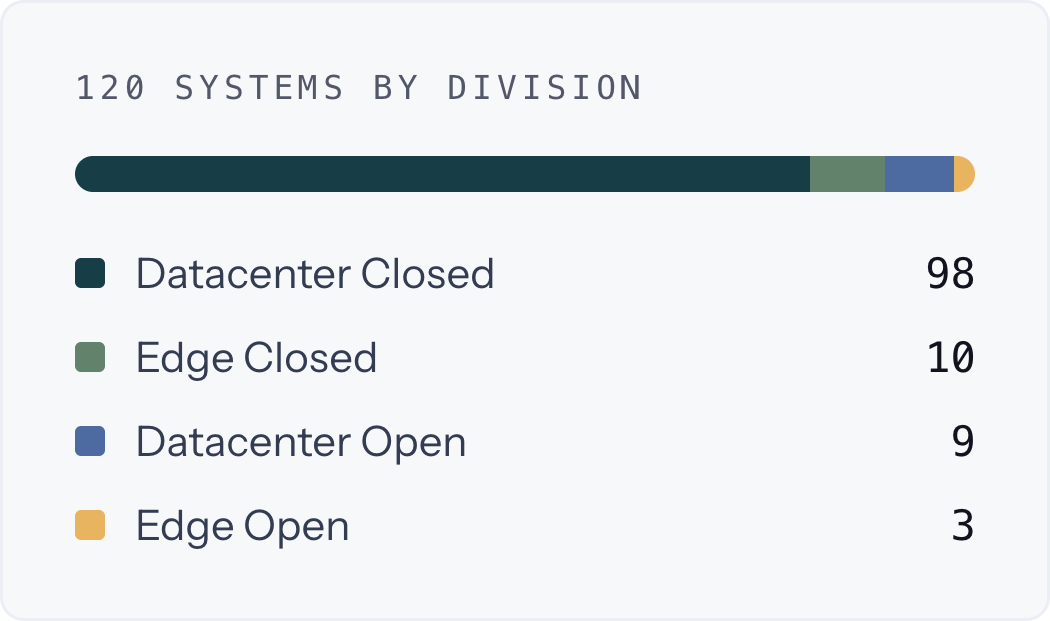
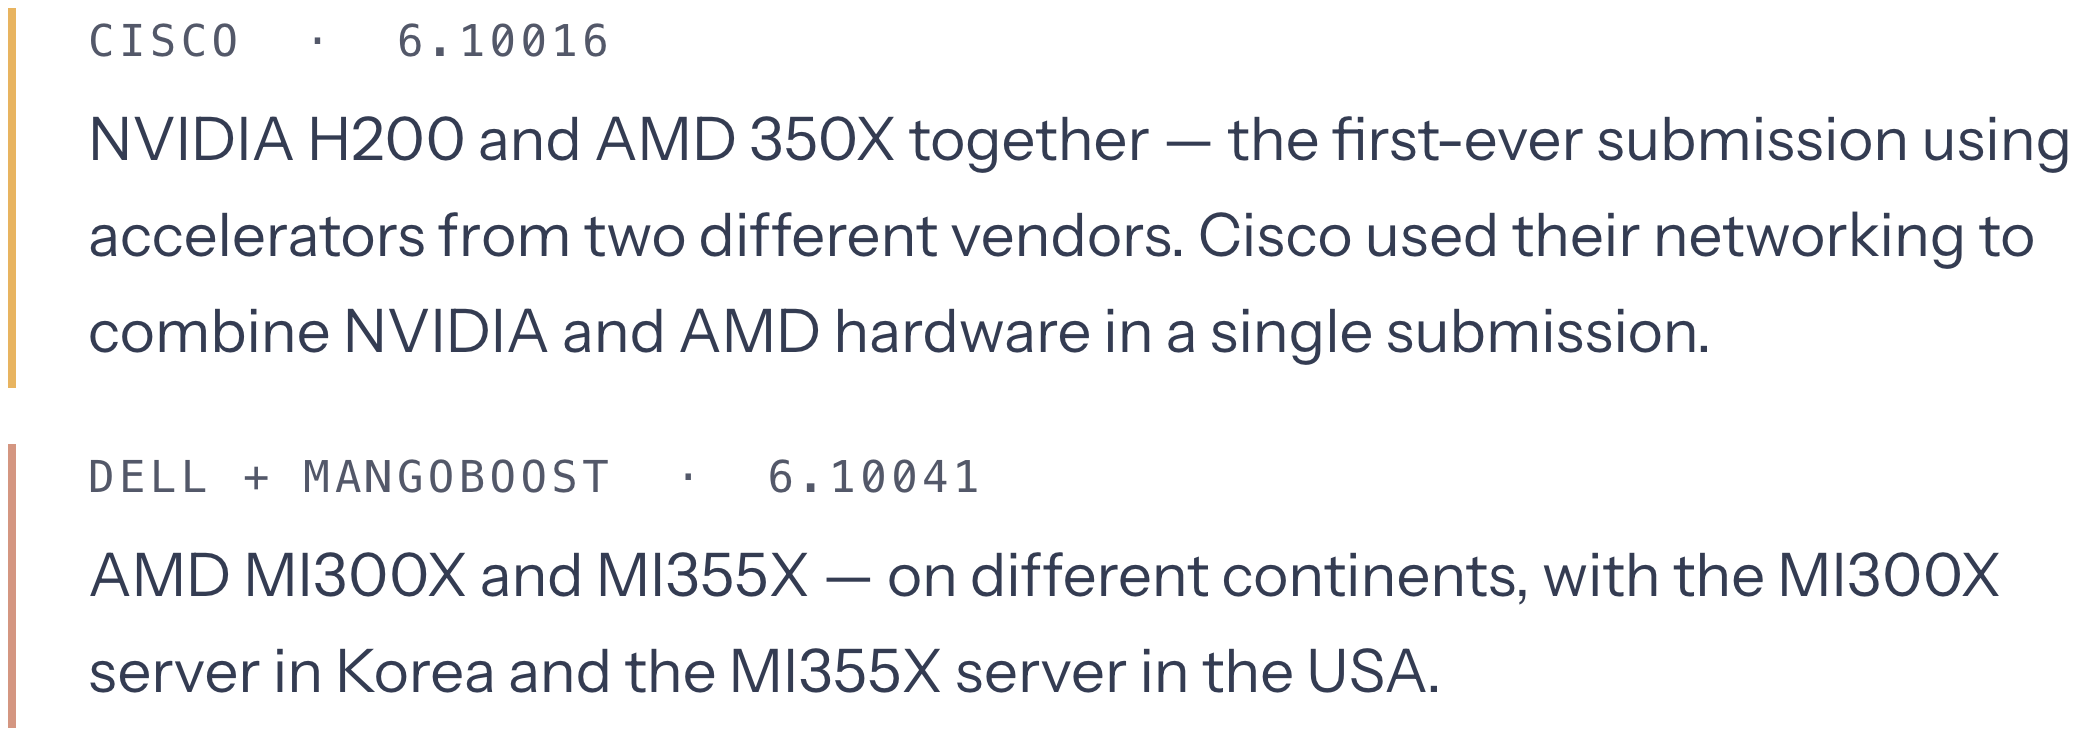
本轮共有30家提交者,涵盖硅厂商、OEM/ODM系统厂商、云及新云服务商以及专业推理软件公司。部分结果为联合提交,包括Dell_AMD、Dell_MangoBoost、RedHat_Intel和RedHat_Supermicro等。总计提交120套系统,覆盖Datacenter与Edge套件及Closed、Open两个赛道。
基准测试概览
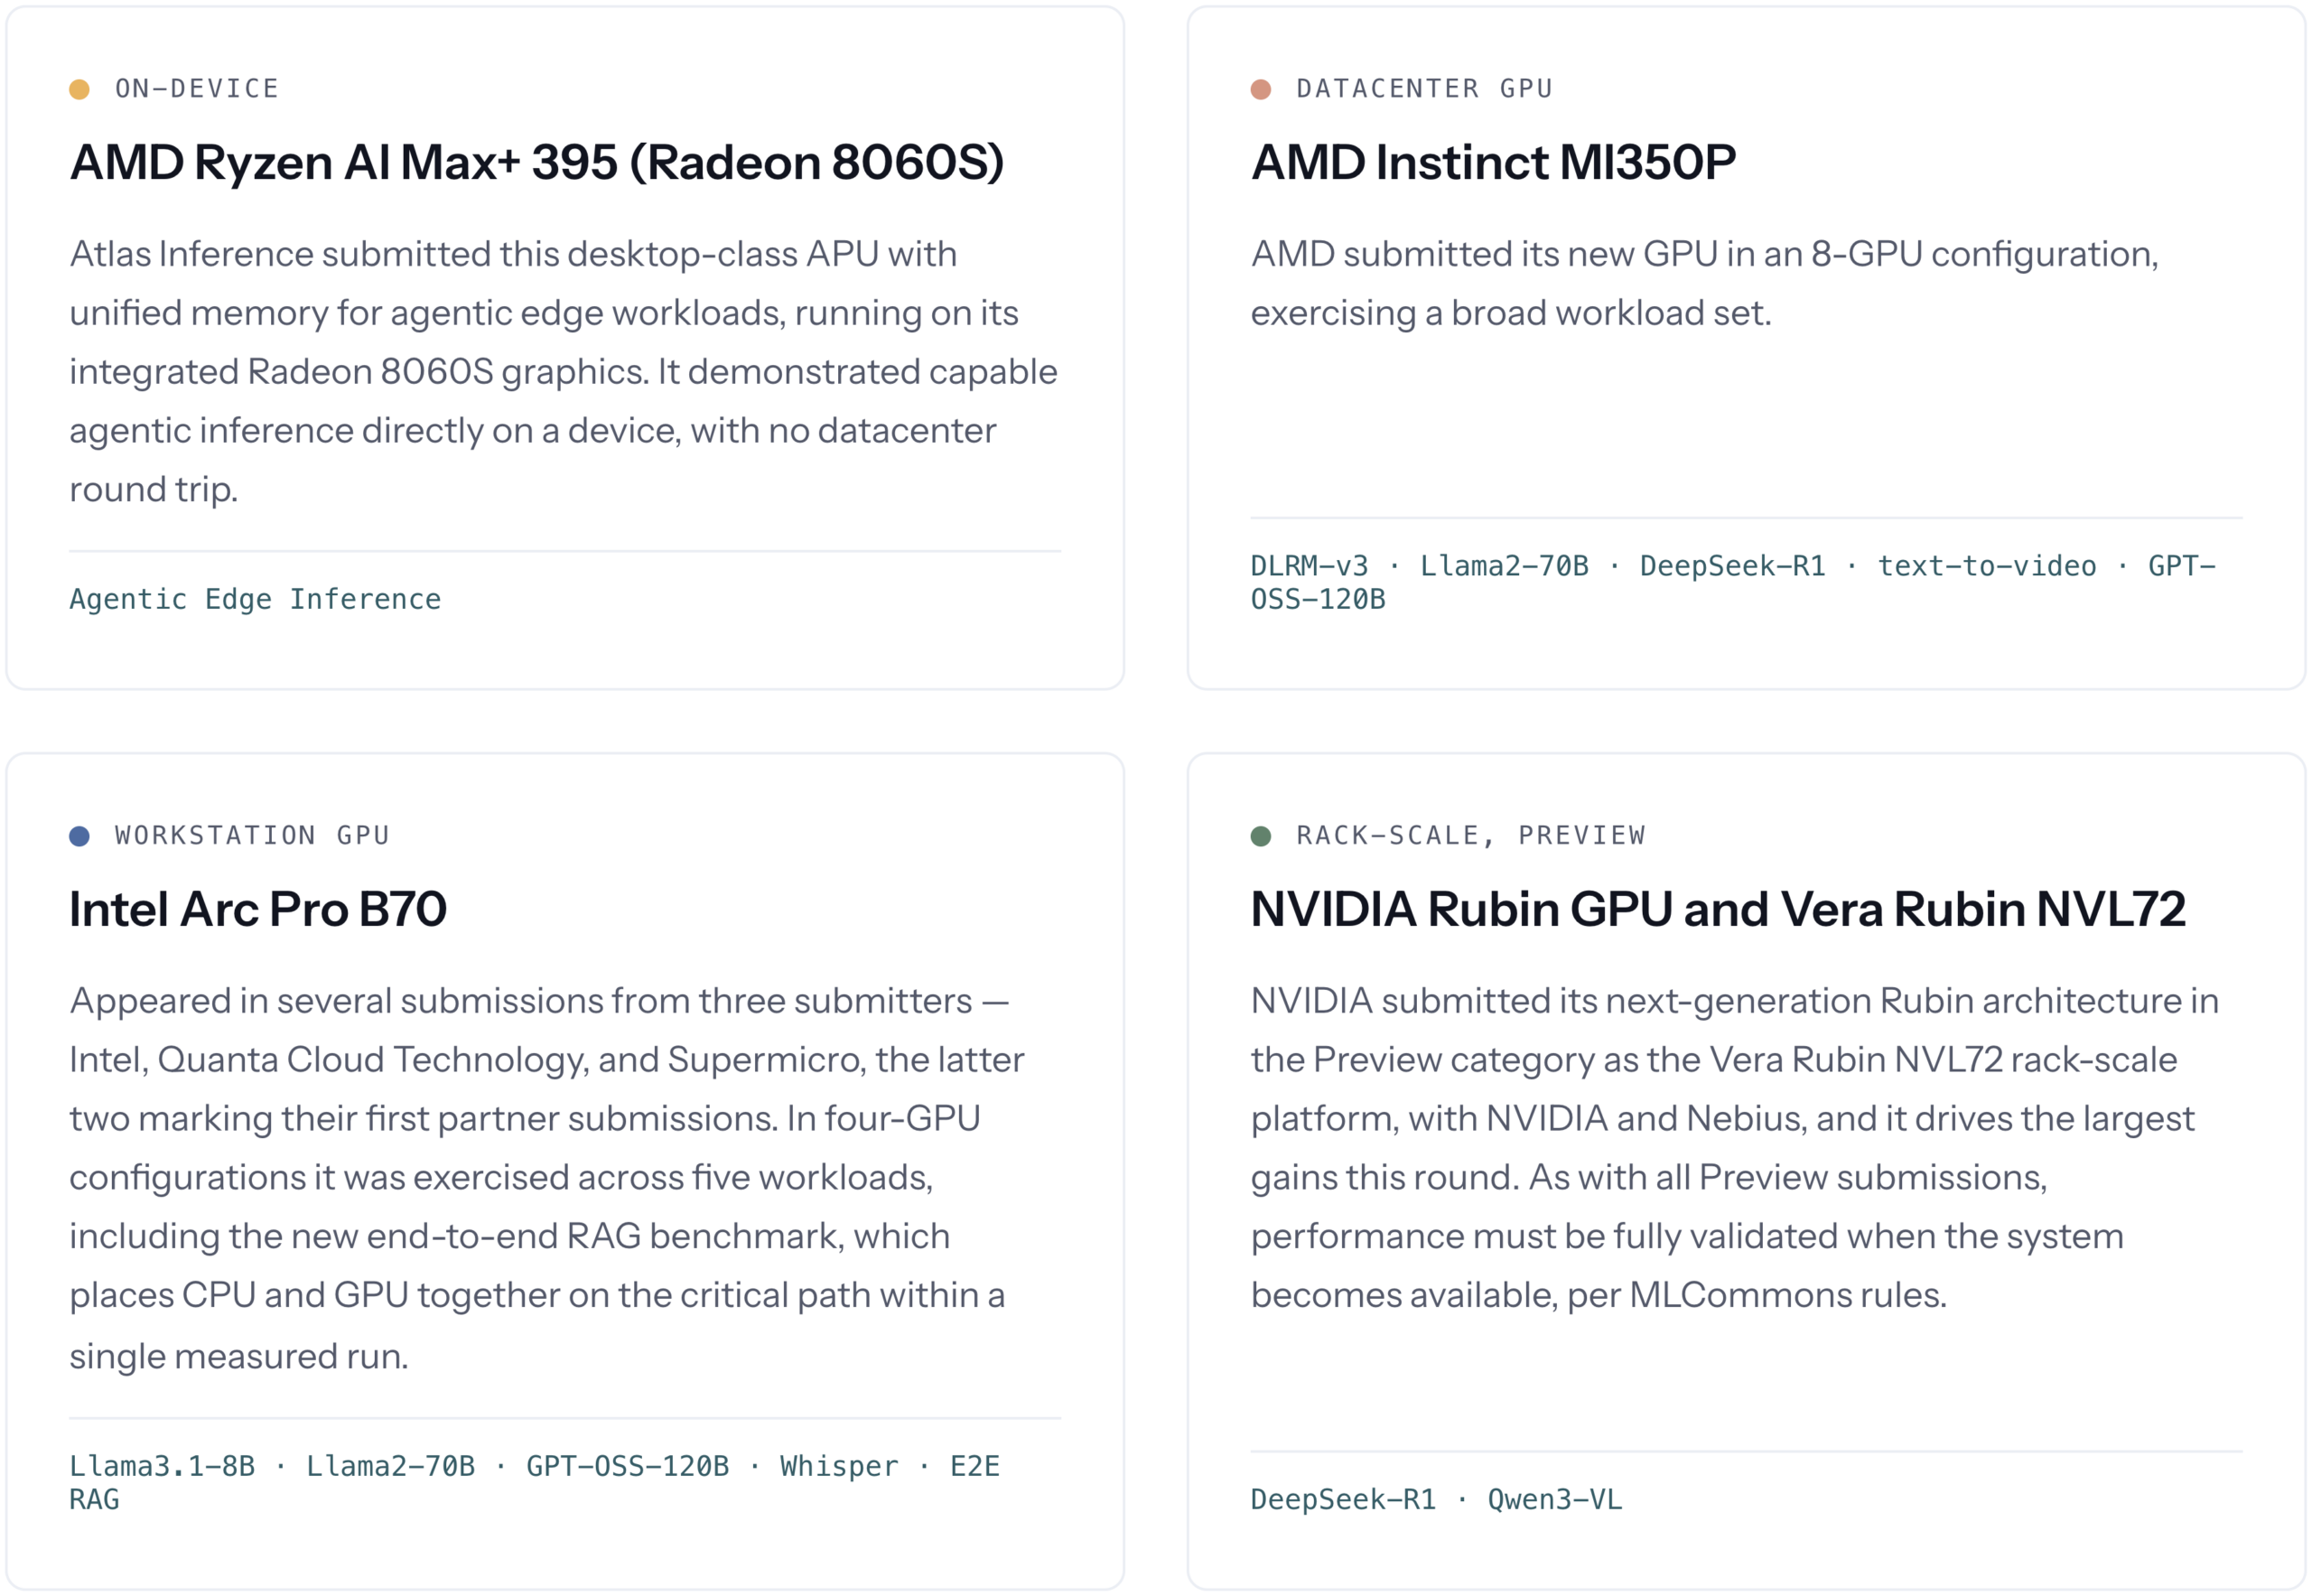
MLPerf Inference v6.1包含10个Datacenter基准和6个Edge基准,其中End-to-End RAG和Agentic Edge Inference为新增项目。VLM新增Interactive场景,GPT-OSS-120B的Interactive场景支持推测解码。Datacenter中最受欢迎的基准已变为gpt-oss-120b,取代此前连续多轮领先的Llama2-70b,表明社区对MoE模型的接受度显著提升。
性能提升分析
与v6.0相比,VLM和DeepSeek R1在Offline与Server场景下取得最大性能增益,主要来自Nvidia Vera Rubin预览系统。其他基准则在相同硬件上通过软件与算法优化实现渐进式提升。
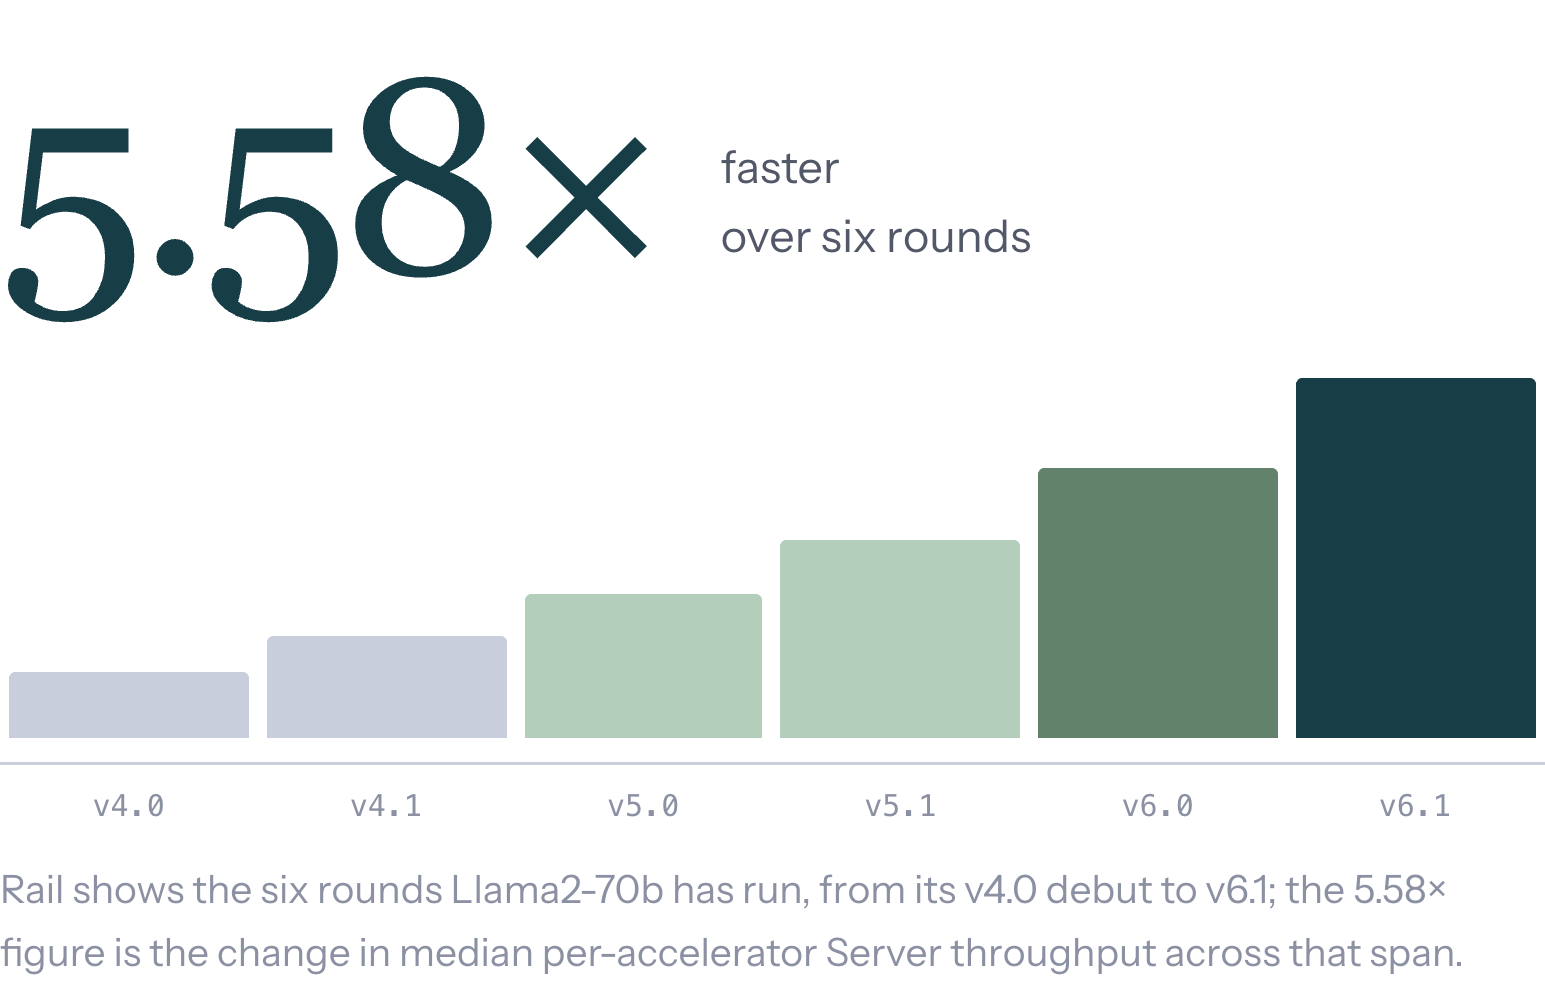
Llama2-70b自v4.0引入以来已运行6轮,Server场景中位每加速器性能累计提升5.58倍。关键驱动因素包括FP4低精度计算、新一代加速器以及持续的软件栈优化。
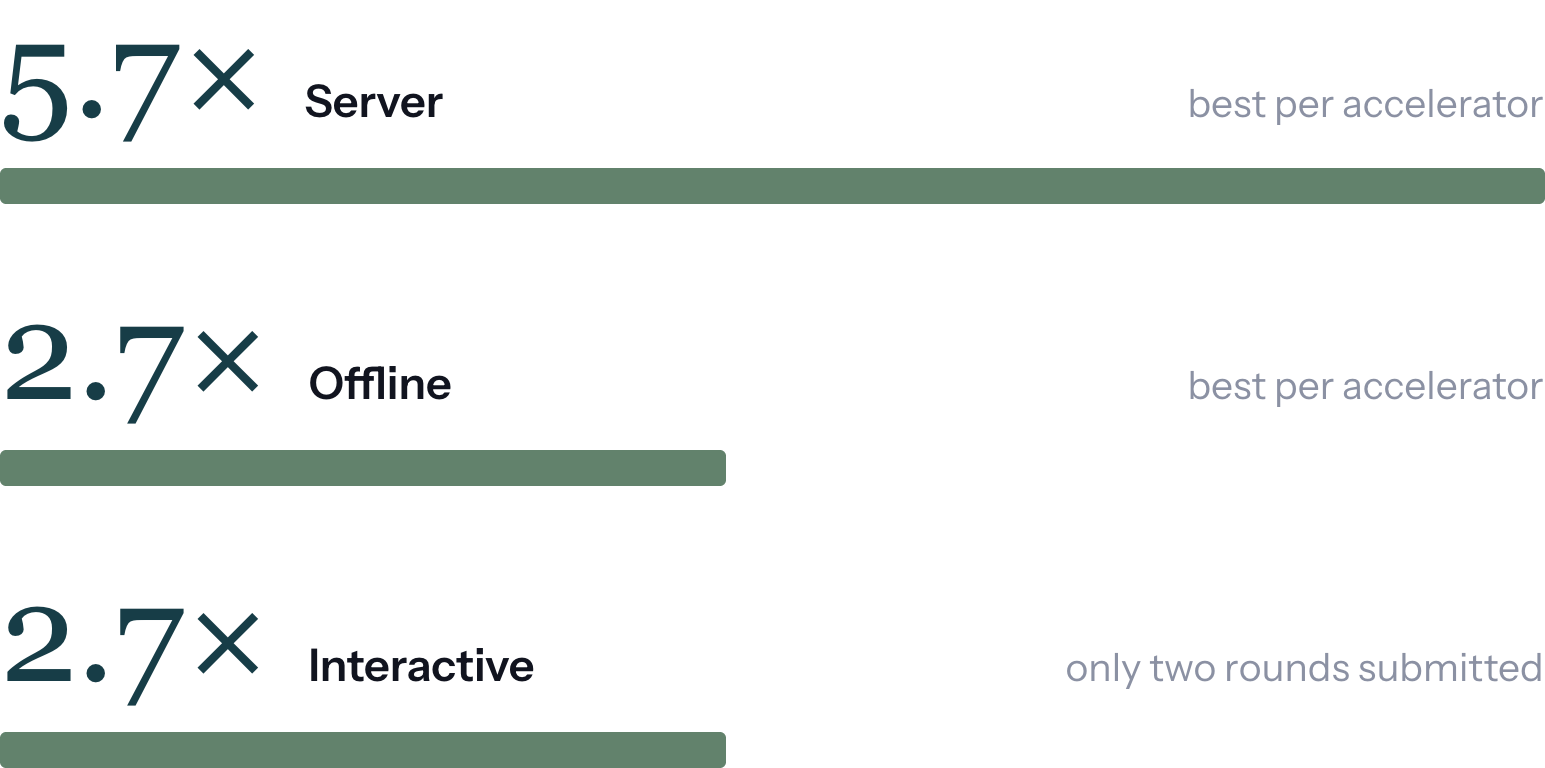
DeepSeek R1基准在一年内Offline性能提升2.7倍,Server场景提升5.7倍,Interactive场景同样实现2.7倍增长。
亮点成果
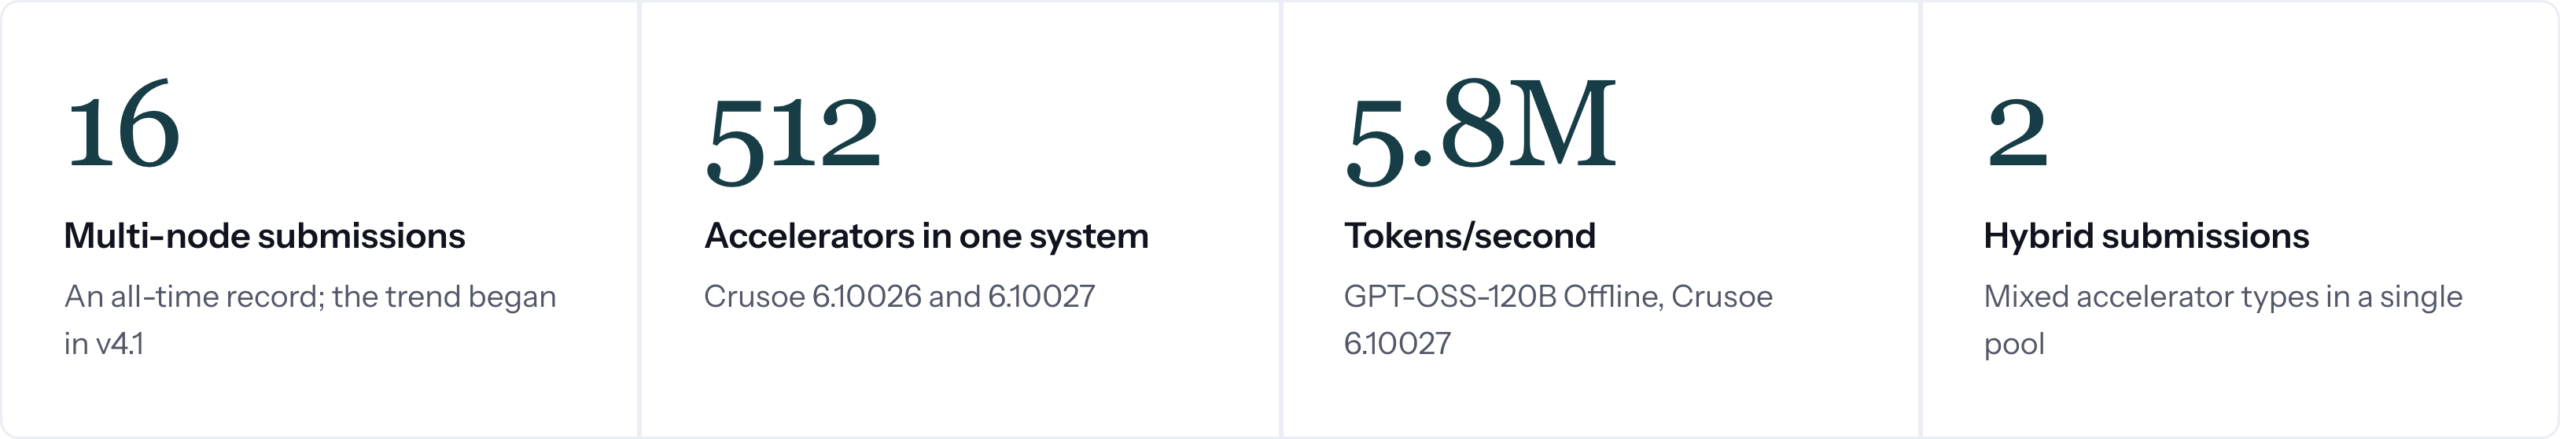
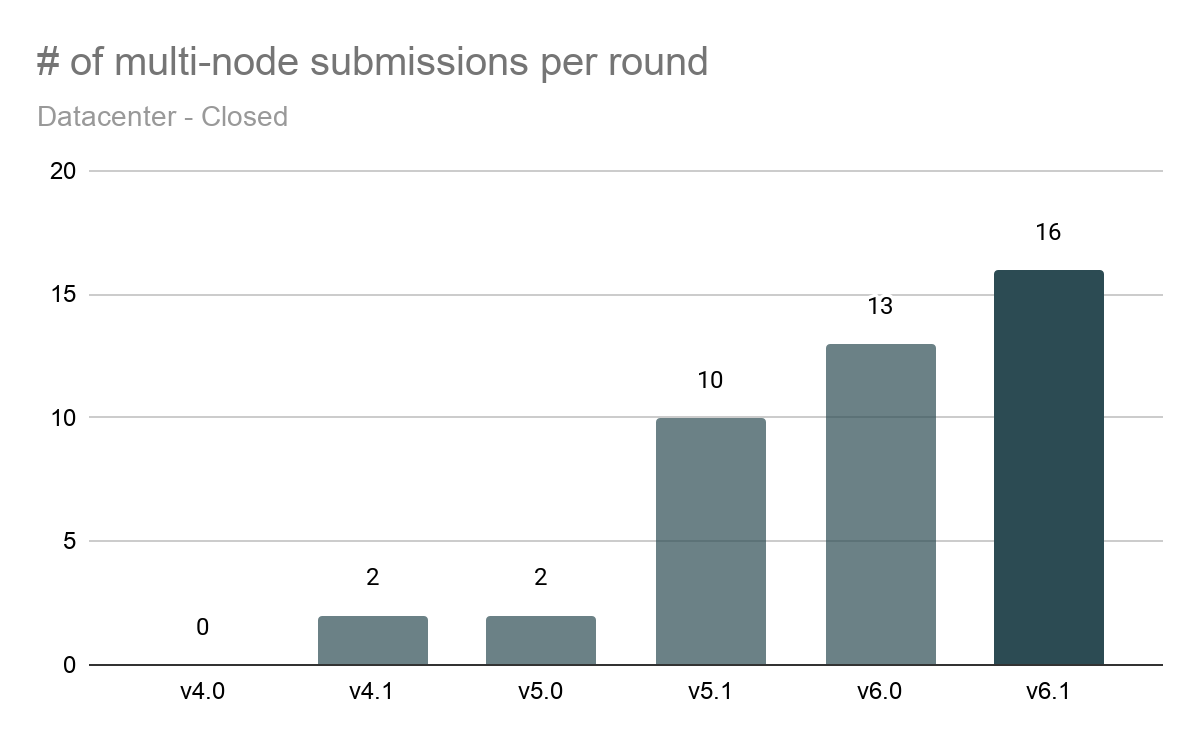
多节点提交数量持续上升,本轮达到历史新高的16个。同时,最大提交系统规模从上一轮的288加速器提升至512加速器。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接