
MLPerf Training 将从 2026 年 10 月的 v6.1 提交轮次开始新增 LLM 后训练基准测试,补充现有的预训练基准套件。预训练通过海量数据构建基础智能,而后训练则通过精炼使模型在特定任务上表现更优。自 2025 年下半年以来,LLM 训练的重大进展多来自后训练规模化,例如小型模型接近前沿性能或在相同基模型上实现代际提升。
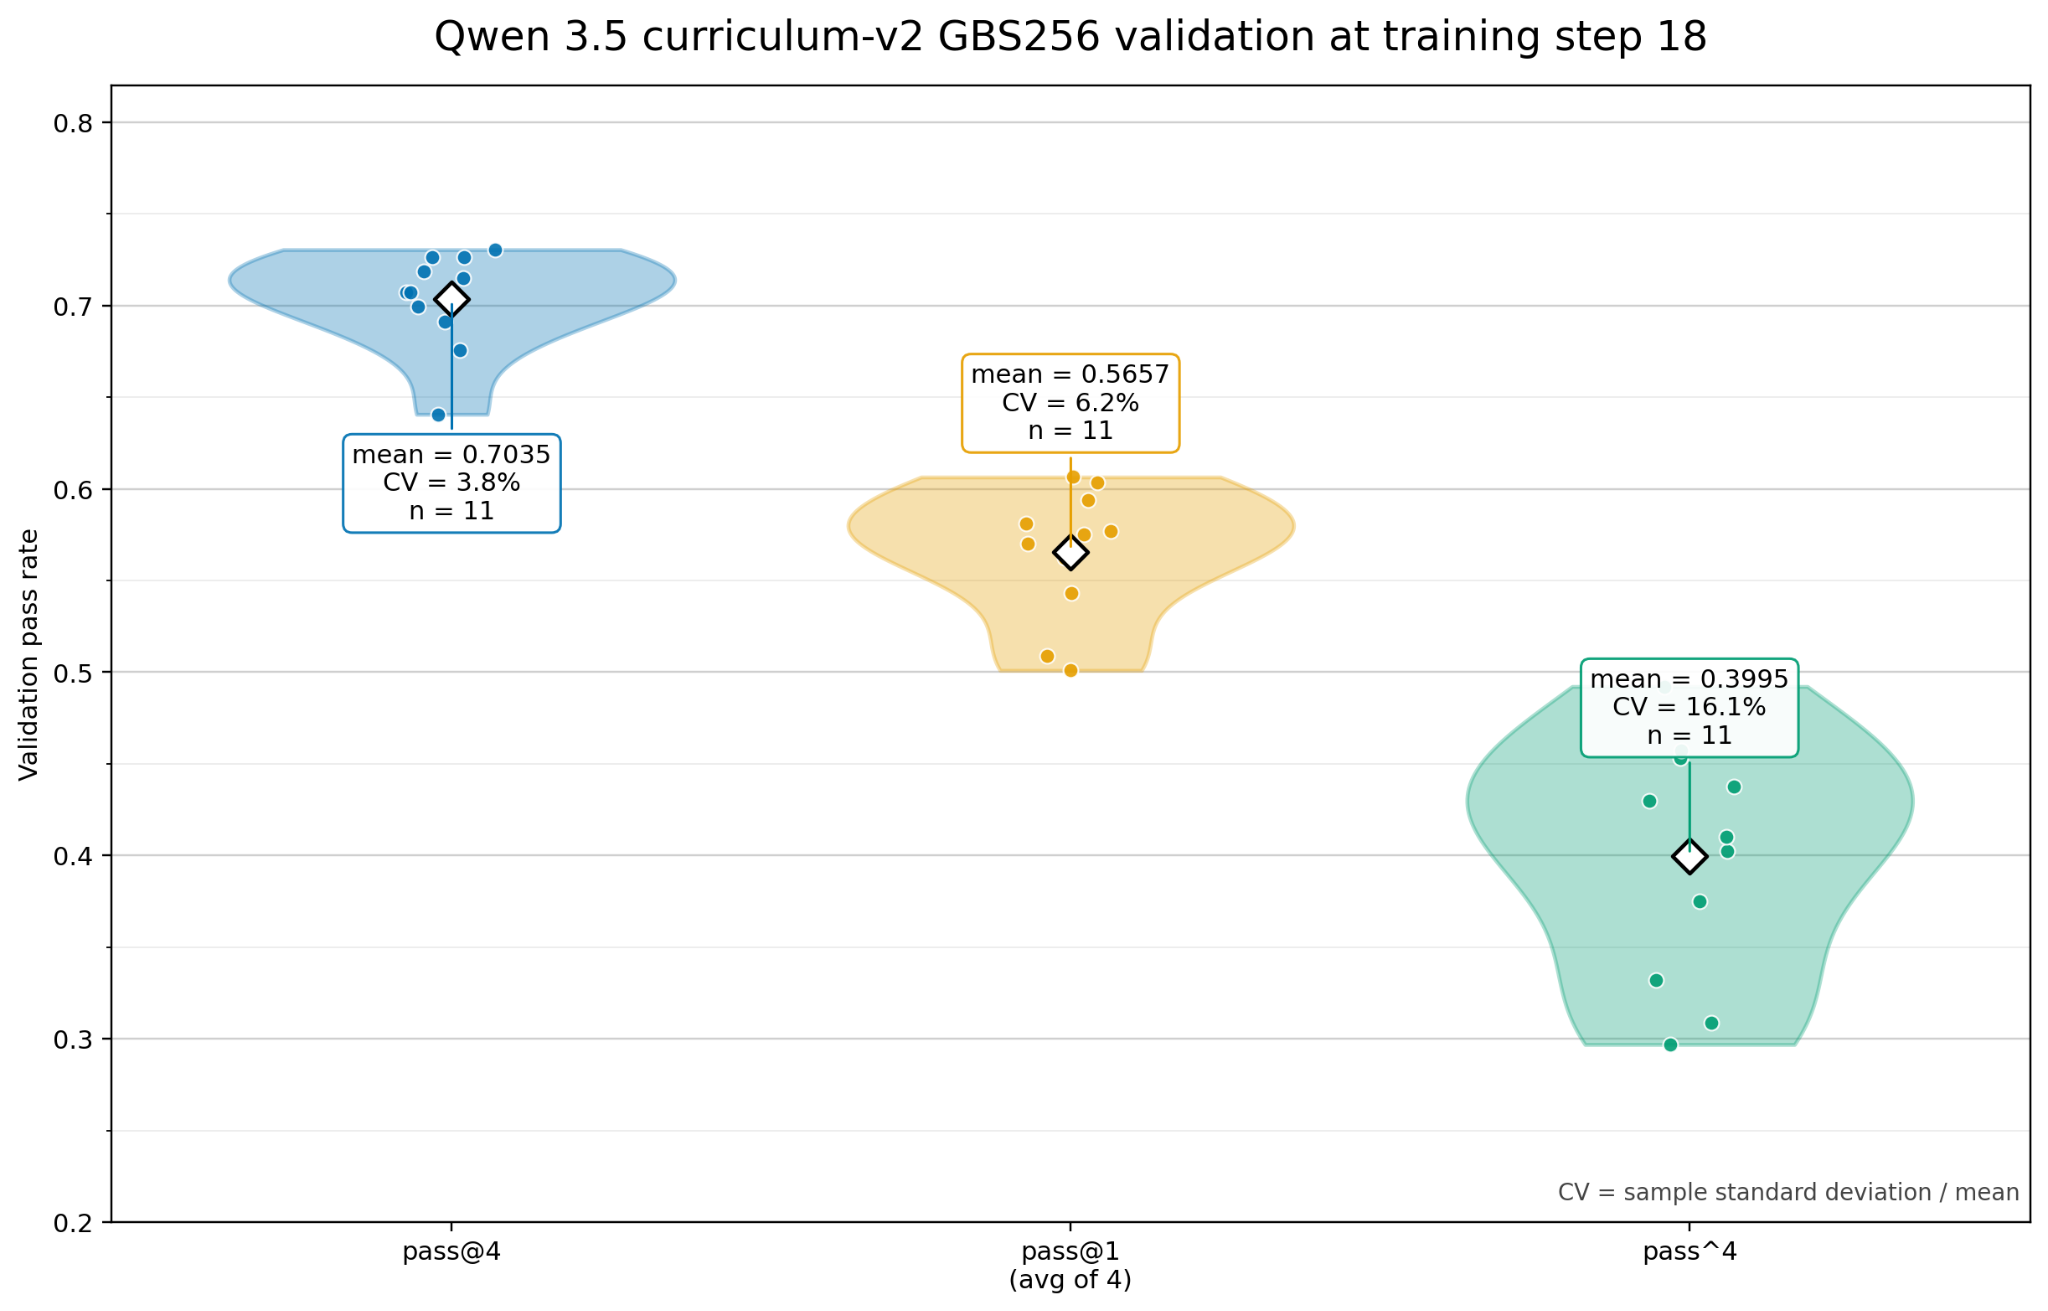
MLPerf Reasoning Task Force 设计了可在 1024 GB300 小时内完成真实 LLM 后训练工作负载的基准。真实后训练融合蒸馏、强化学习与监督微调,涵盖数学、推理和代理任务。任务组最终选定强化学习与可验证奖励(RLVR)方法,适用于软件任务场景。LLM 驱动的编码代理在沙箱环境中解决代理软件工程(SWE)任务,每次尝试称为 rollout。系统对每个问题采样多个 rollout 并给予二元通过/失败奖励,随后使用组相对策略优化(GRPO)更新模型。
模型选择
基准选用 2026 年 2 月发布的 Qwen 3.5 397B 模型,这是 Qwen 3.5 系列中参数最大的开放权重模型,采用 Apache 2.0 许可。该模型为混合专家(MoE)架构,总参数 3970 亿,每 token 激活 170 亿参数。它首次产品化 Gated DeltaNet(GDN)与稀疏 MoE 混合架构,每个 MoE 层激活 1 个共享专家和 512 个路由专家中的 10 个(2%)。GDN 以固定大小压缩状态替代线性增长的 KV 缓存,特别适合长上下文场景。
数据集选择
基准使用 Apache 2.0 许可的 R2E-Gym SWE 问题数据集,包含来自多个 Python 项目的 GitHub 提交生成的 700 个训练问题和 251 个验证问题。代理在预装依赖的 Linux 容器中接收问题描述,需生成修复补丁。任务组对数据集进行了难度筛选,并修复了跨架构兼容性问题。
环境与实现
基准限制最大上下文 65536、最大 30 个代理回合和每提示 16 次生成。参考实现基于 NVIDIA NeMo-RL,使用 Ray 协调策略训练与 rollout 生成,分别由 Megatron Core、vLLM 和 OpenHands harness 支撑。评估时使用代理不可见的测试文件以防止奖励黑客攻击。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接