NVFP4 KV Cache 加速长上下文与 Agent 推理

NVFP4 KV Cache 加速长上下文与 Agent 推理

KV 缓存是现代 LLM 推理系统的核心组件。多轮 Agent 会话的上下文以键值对形式缓存于 GPU 内存中,供后续解码步骤复用。随着上下文窗口扩大,KV 缓存对显存容量和带宽的压力日益增大。

NVFP4 格式与双级缩放

NVIDIA 在 Blackwell 架构中推出 NVFP4 格式,采用 E2M1 四位值配合每块 16 值的 FP8 块级缩放和 FP32 张量级缩放,有效控制量化误差。
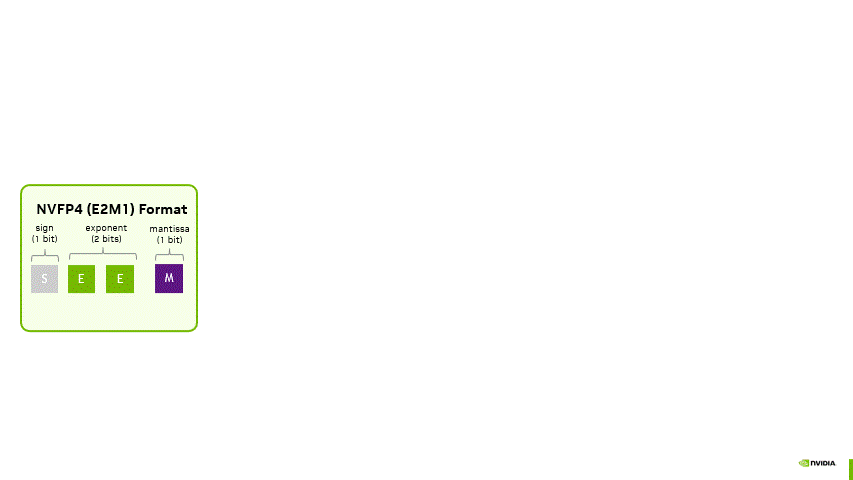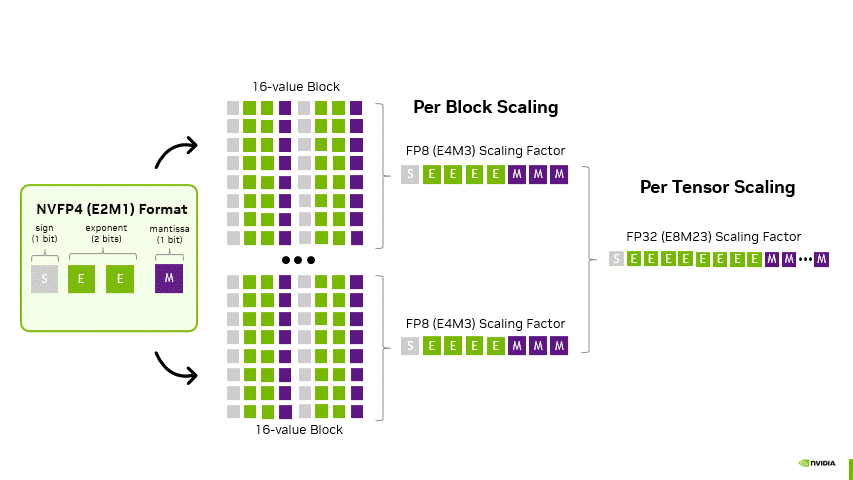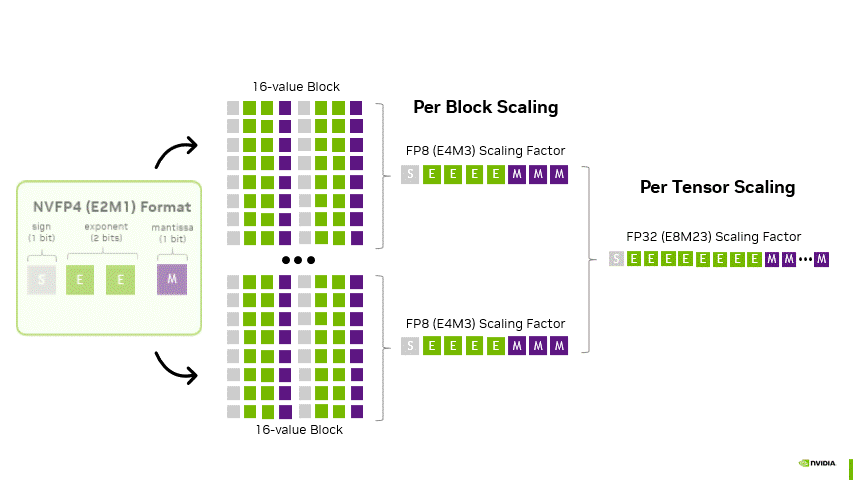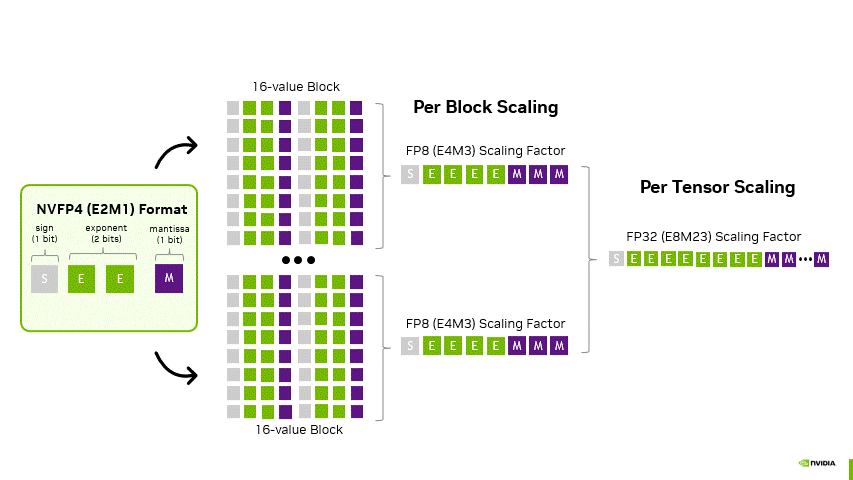
Figure 1. NVFP4 two-level scaling per-block and per-tensor quantization strategy

SGLang 中的 NVFP4 KV 实现

实现连接 SGLang 分页 KV 缓存与三种注意力路径:初始预填充、块状预填充/扩展以及解码。
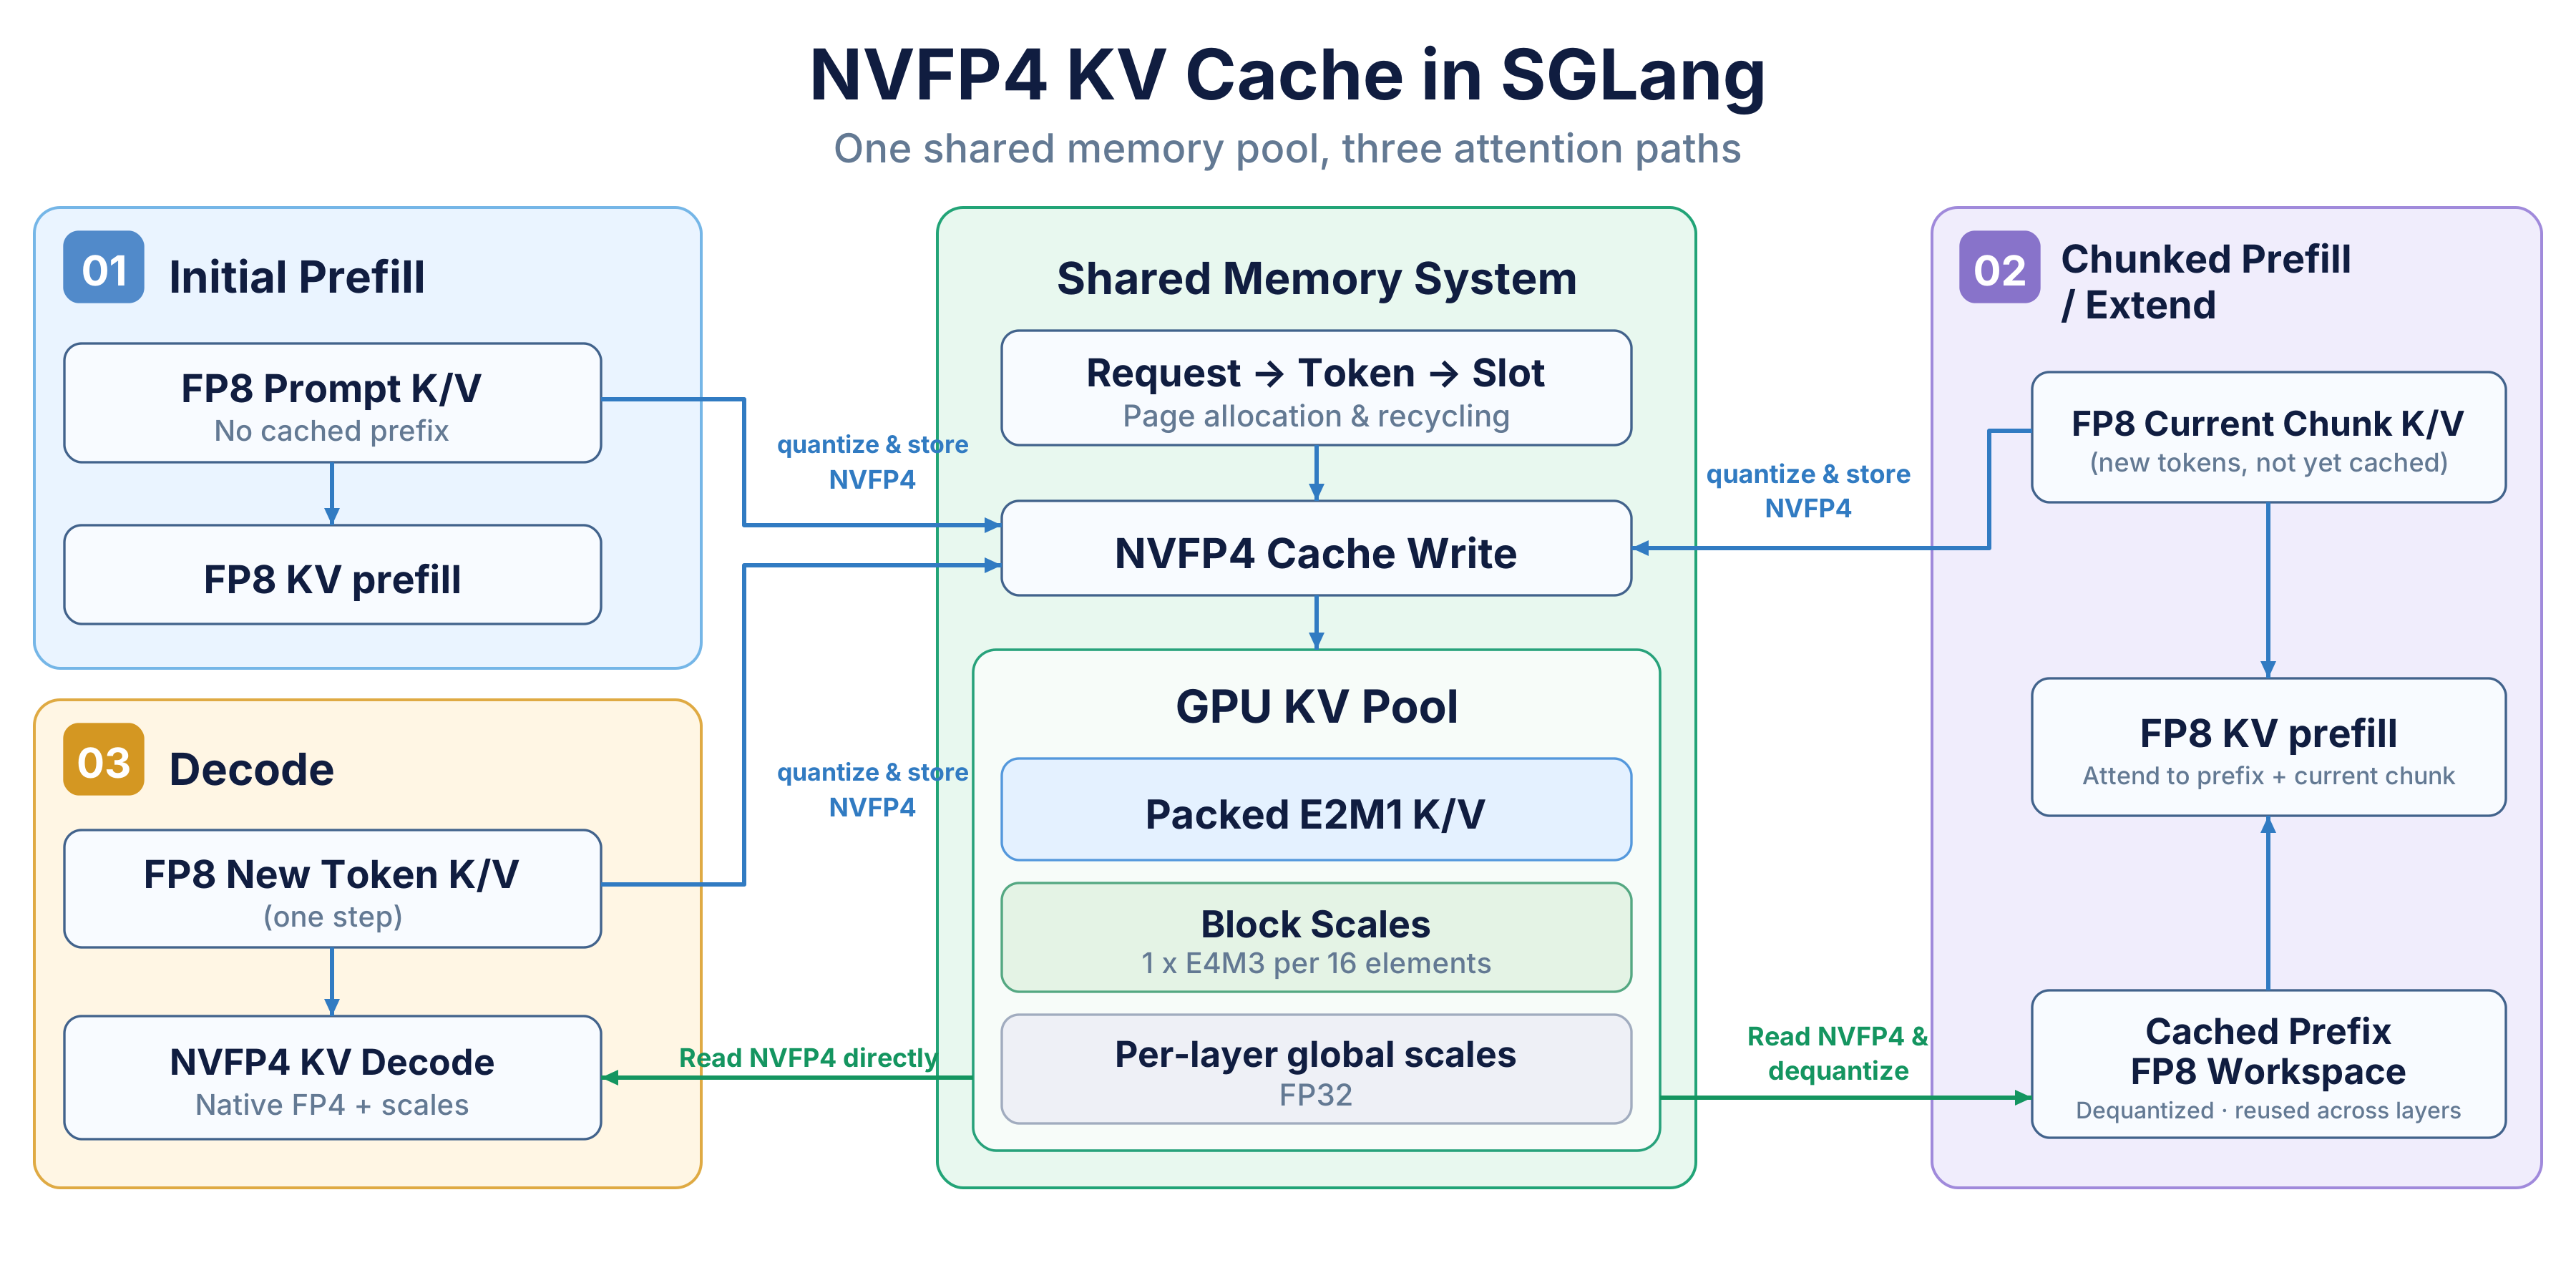
Figure 2. NVFP4 KV cache implementation in SGLang

解码注意力内核设计

解码阶段内核直接从 NVFP4 KV 缓存读取数据,在内核内完成到 FP8 的实时反量化,避免额外内存往返。
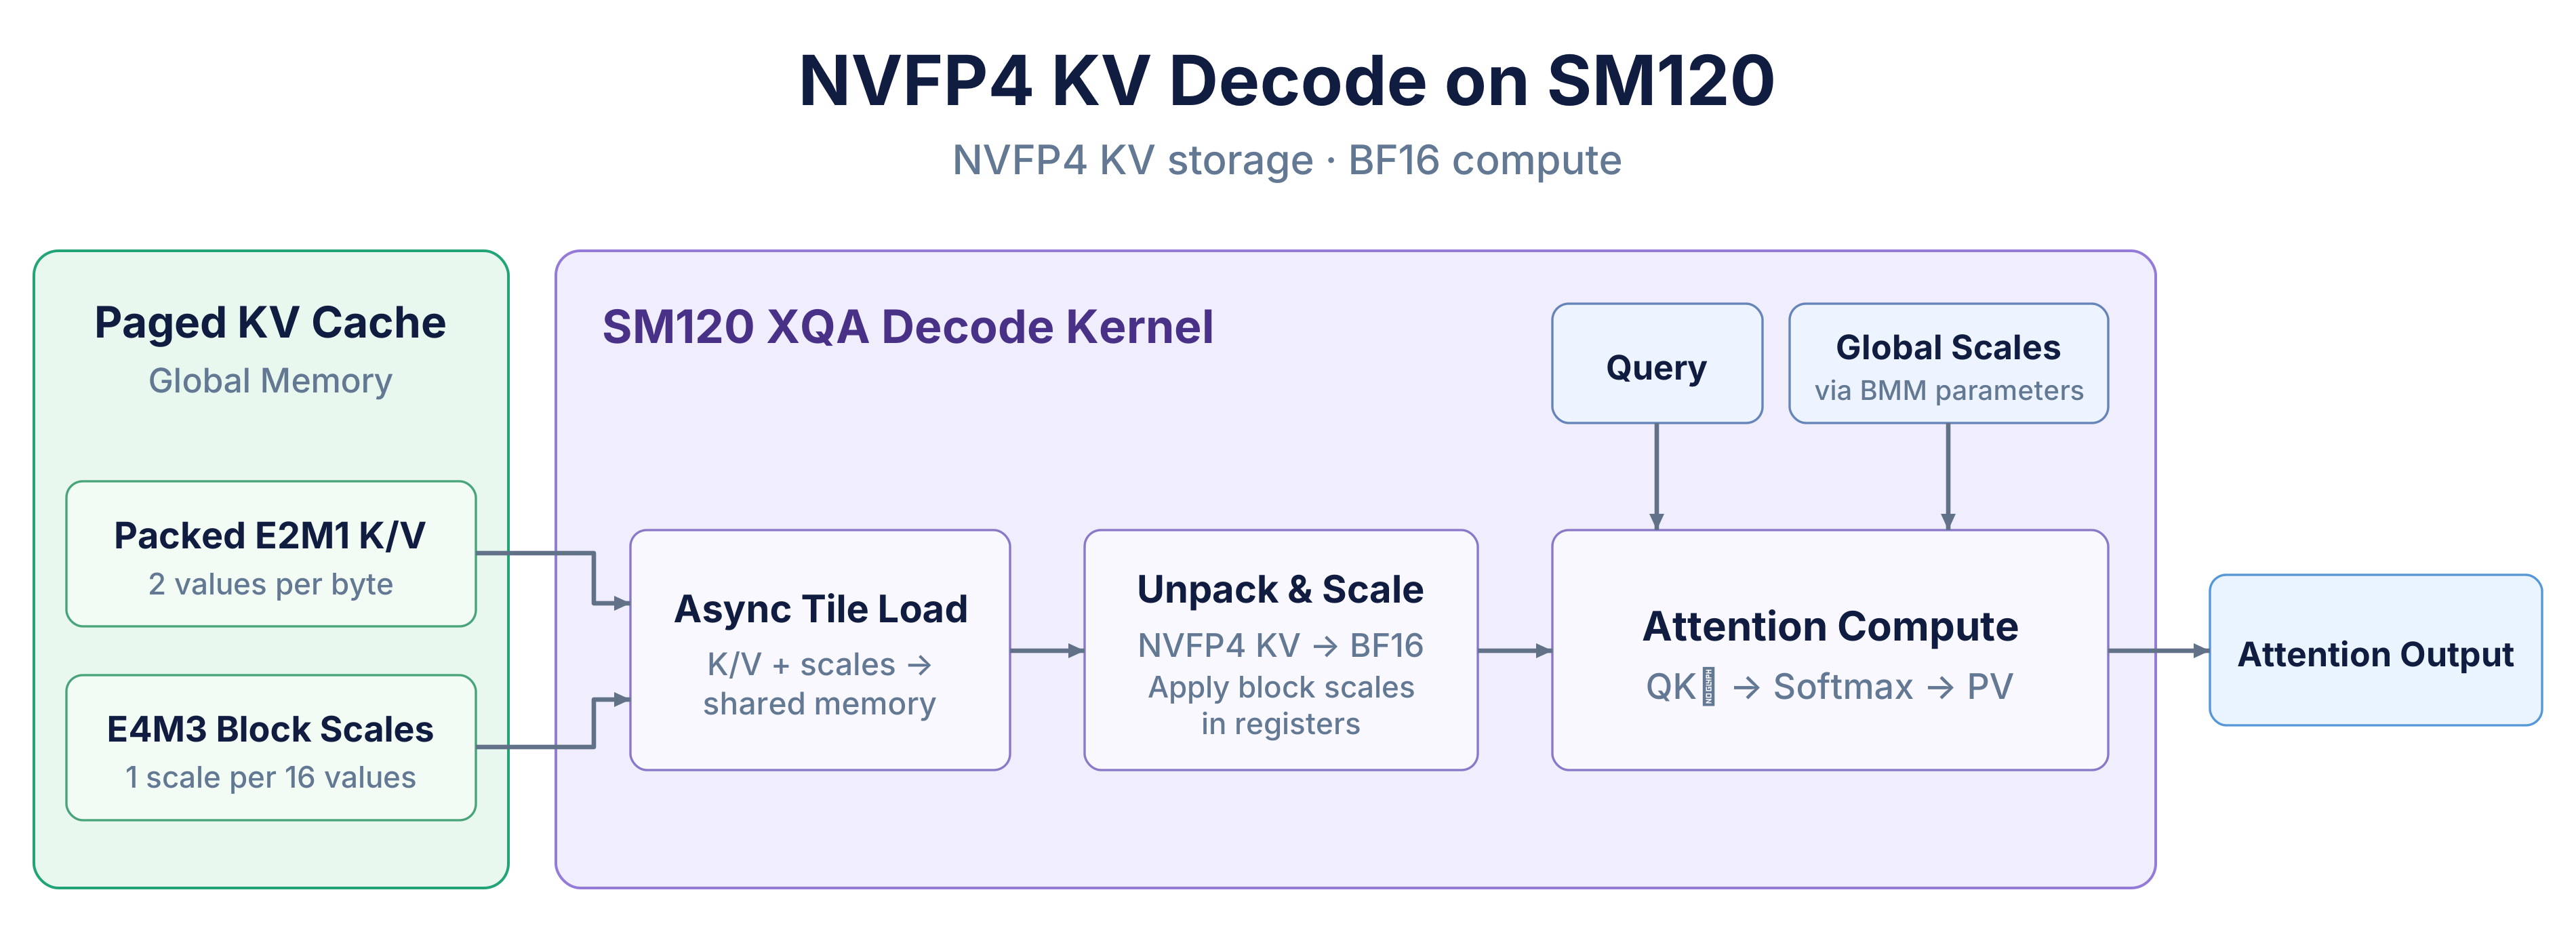
Figure 3. NVFP4 KV attention decode kernel design

精度评估

在 Qwen3.5-397B-A17B 上,NVFP4 与 FP8 精度差异极小(<0.1%)。Qwen3.8-27B 上部分任务精度下降 0.3-1.6 个百分点。
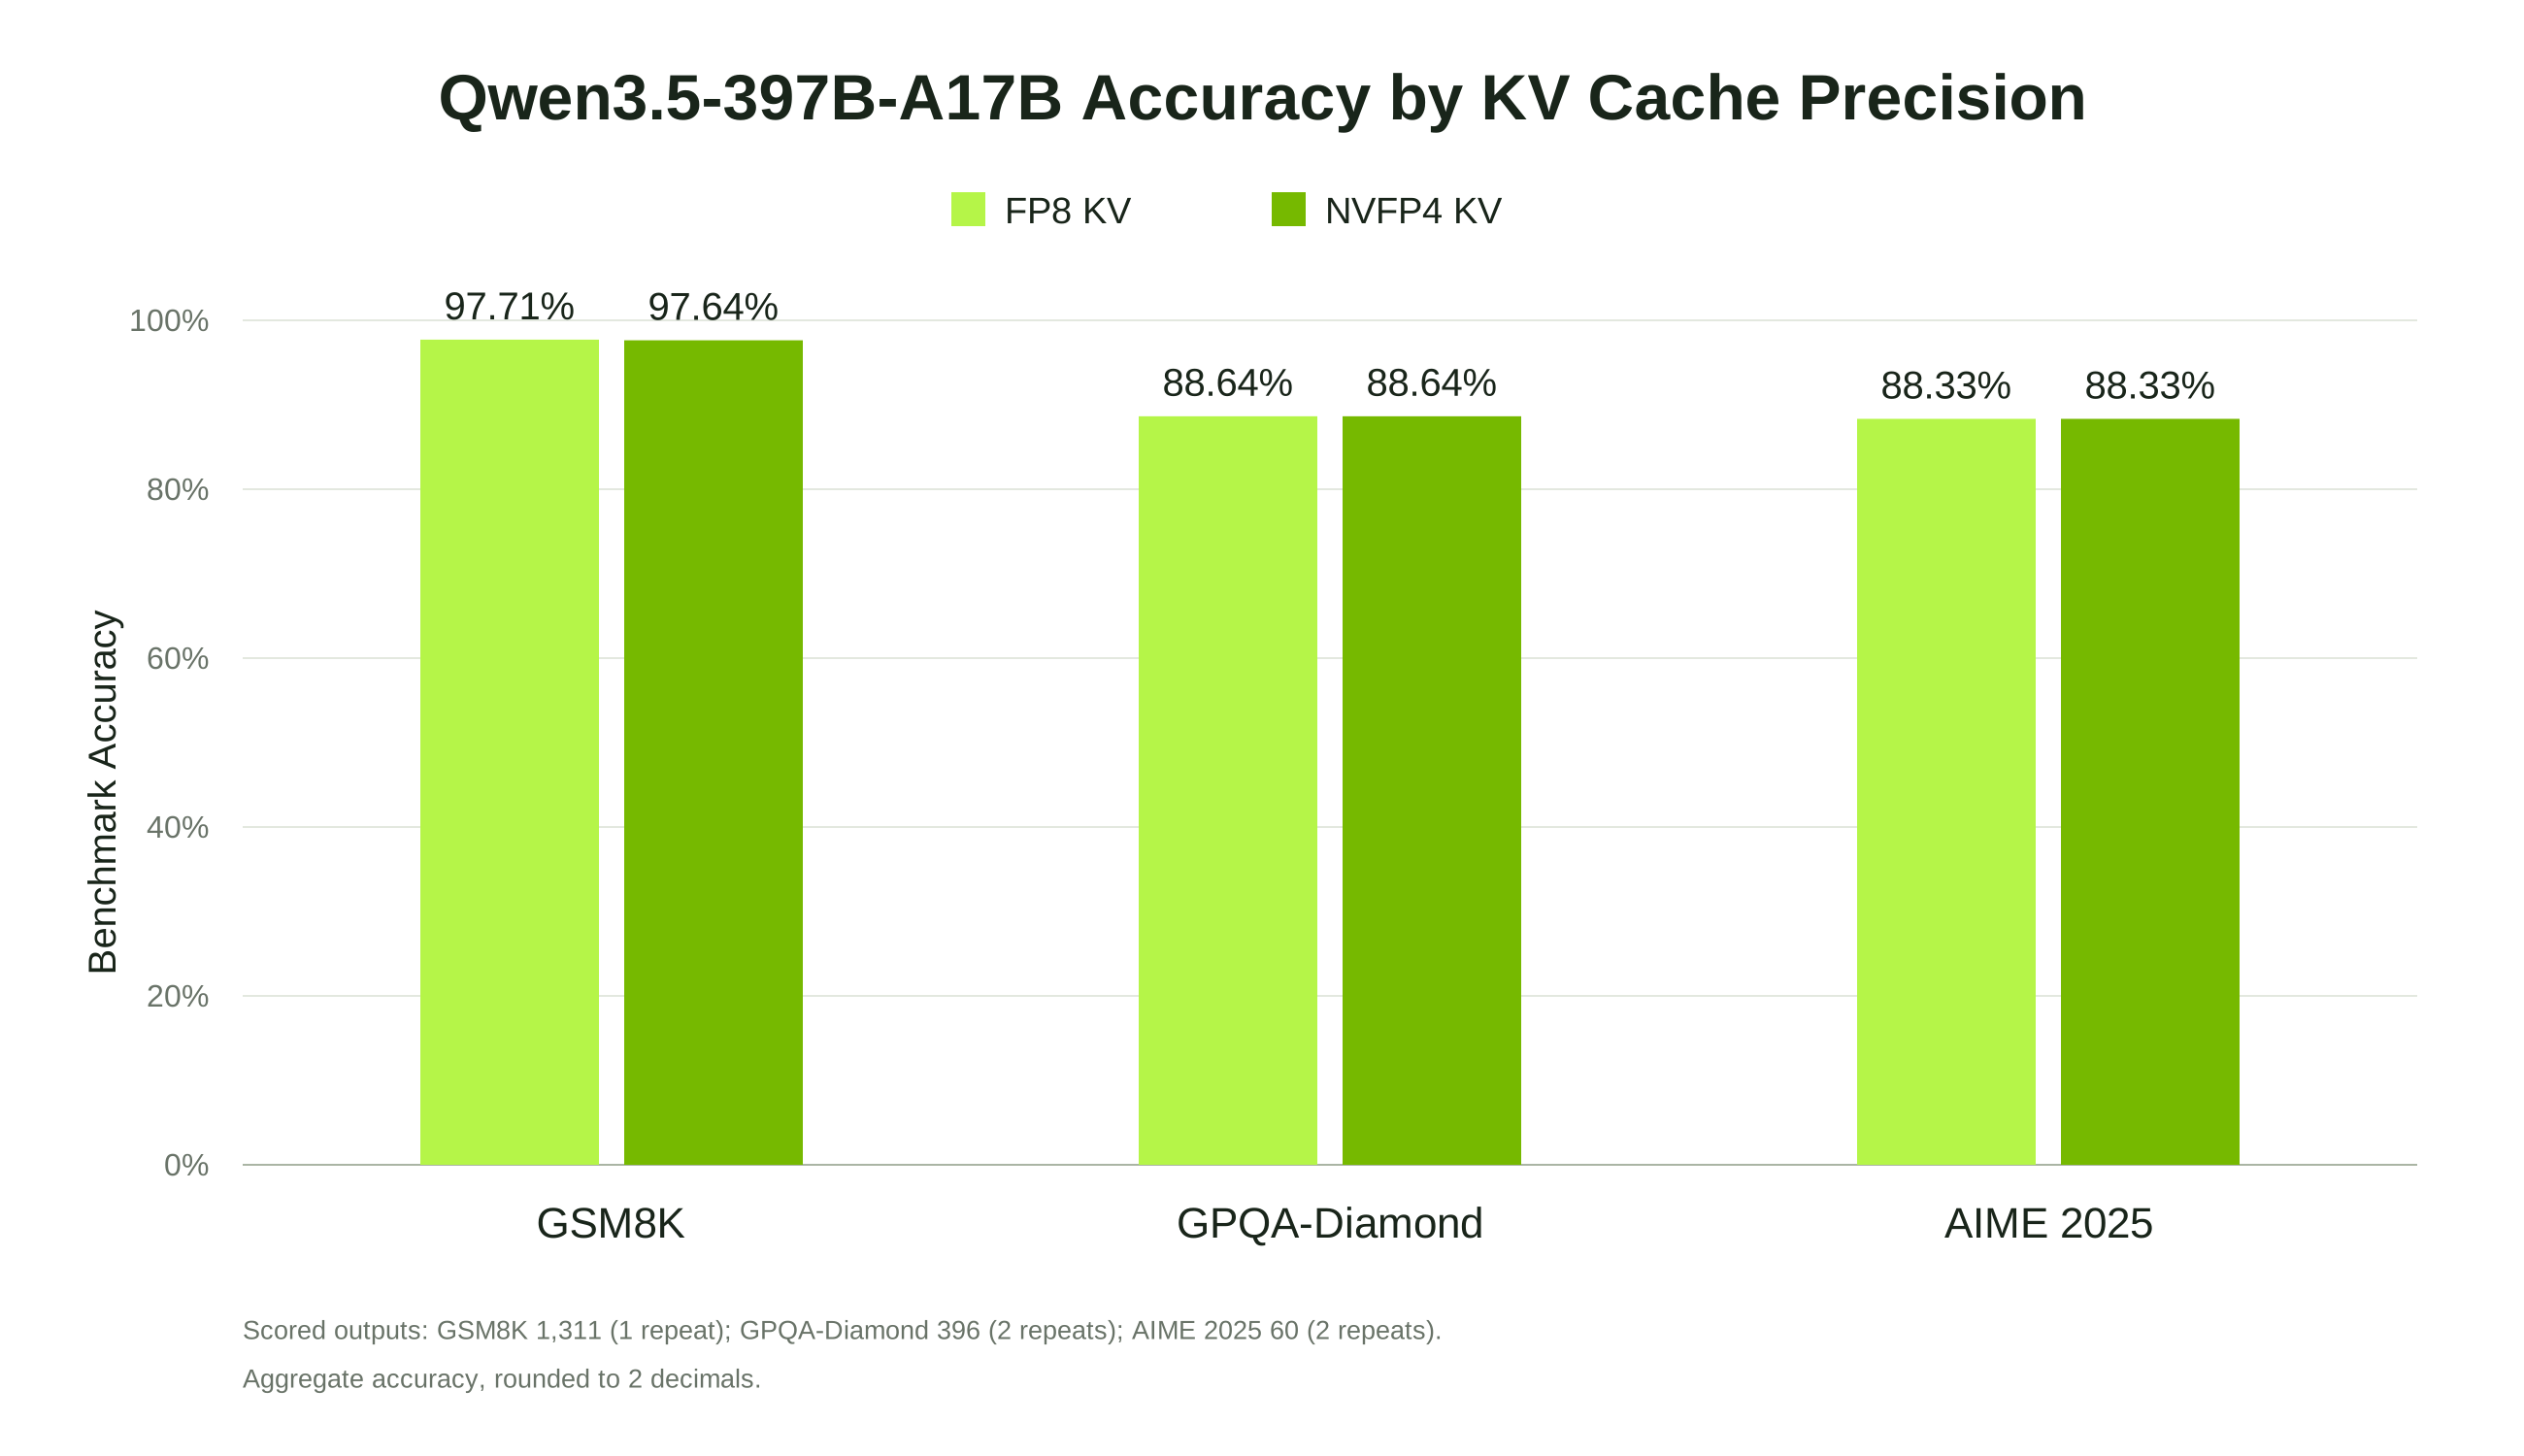
Figure 4. Accuracy benchmark on Qwen3.5-397B-A17BFigure 5. Accuracy benchmark on Qwen3.8-27B

性能表现

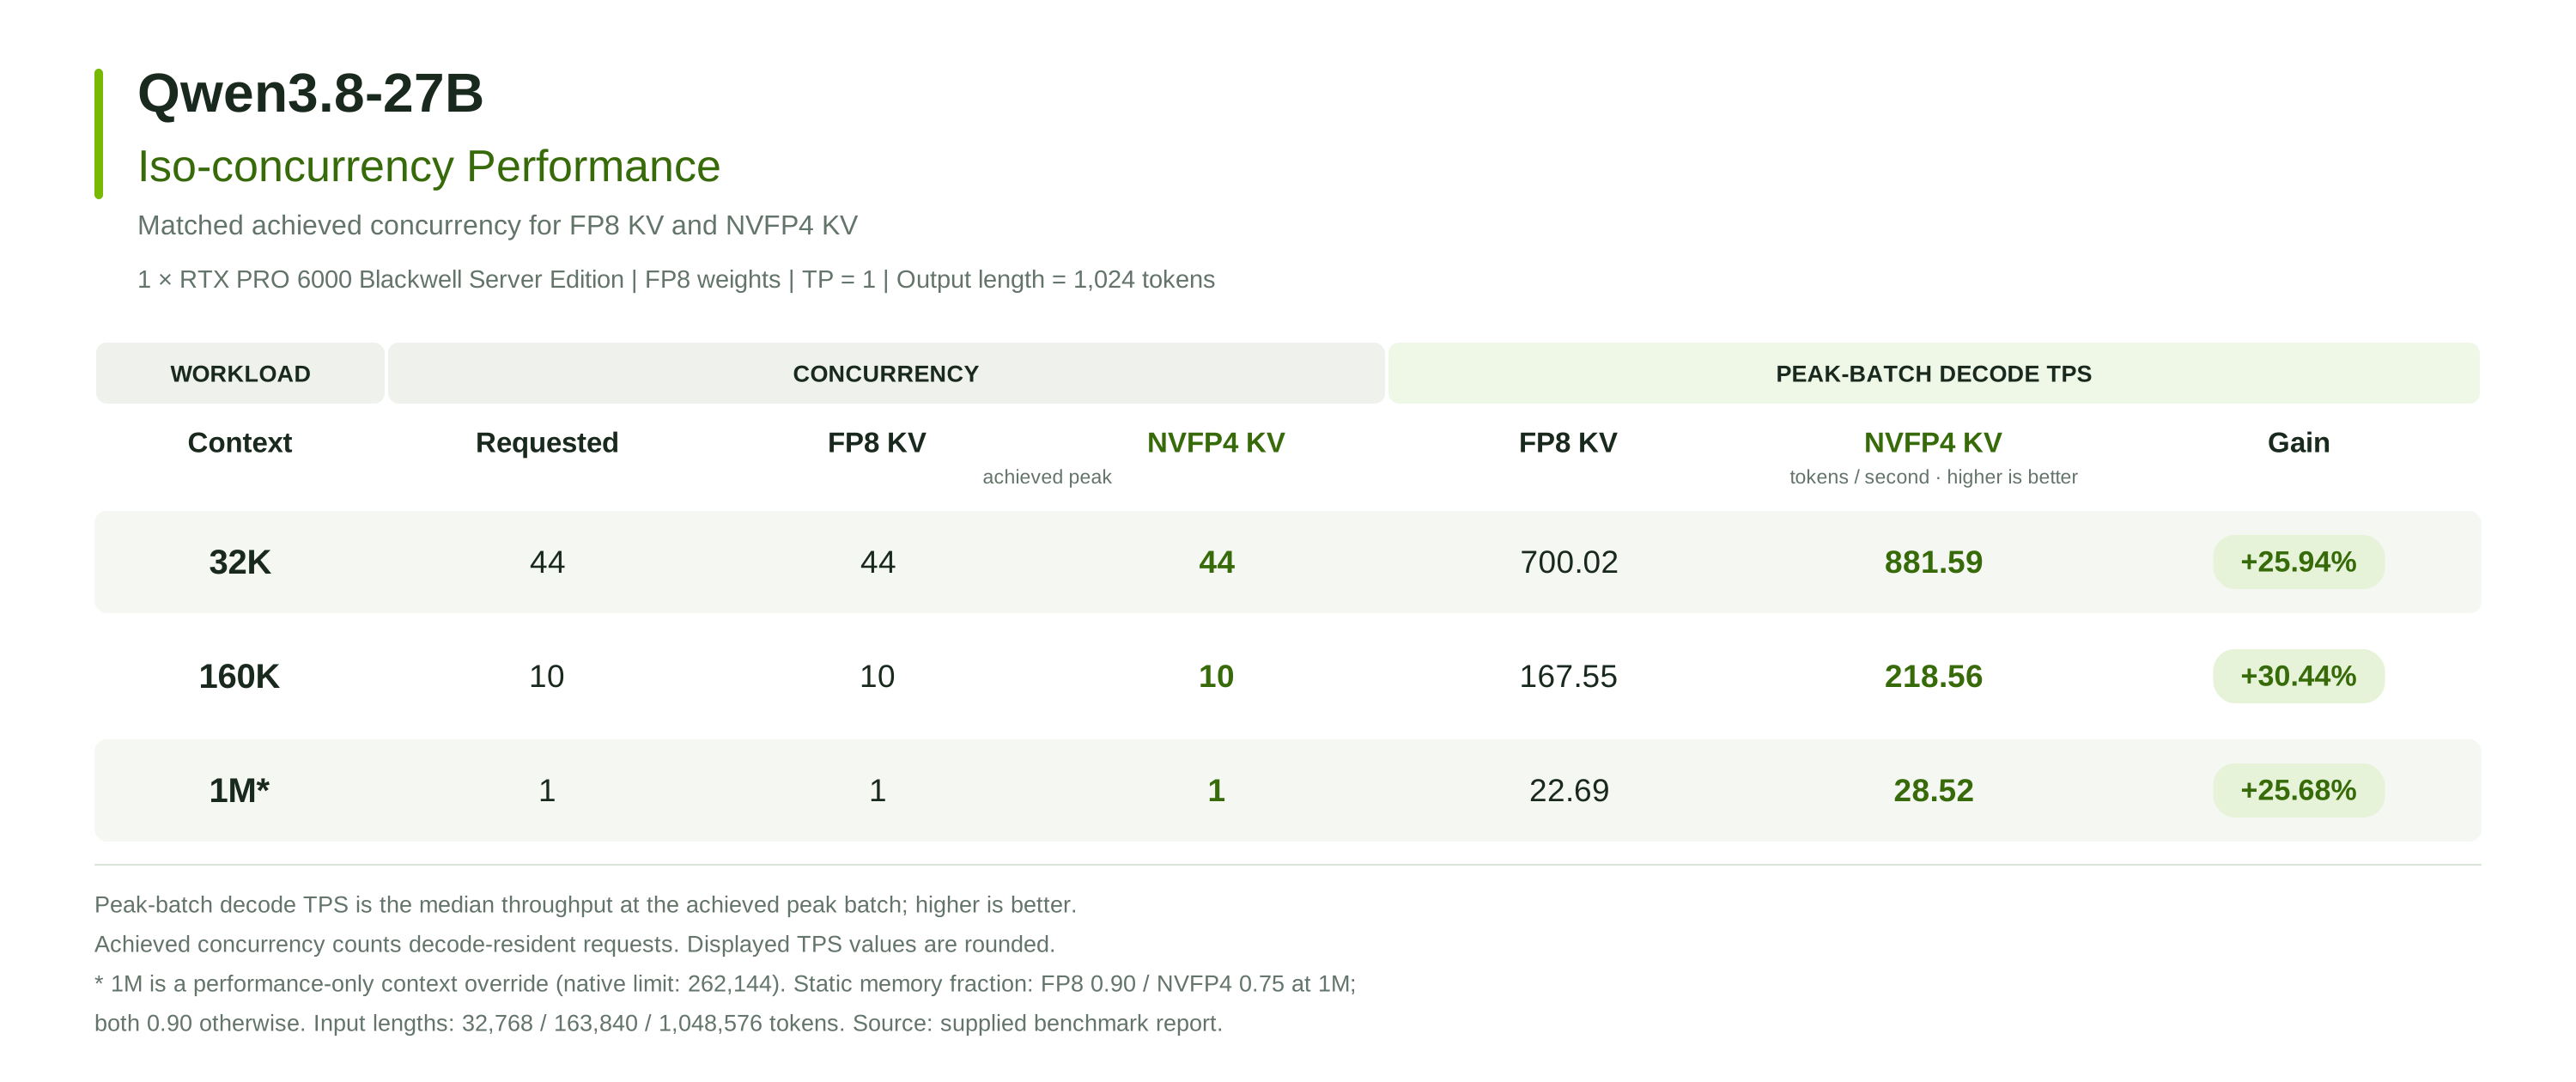
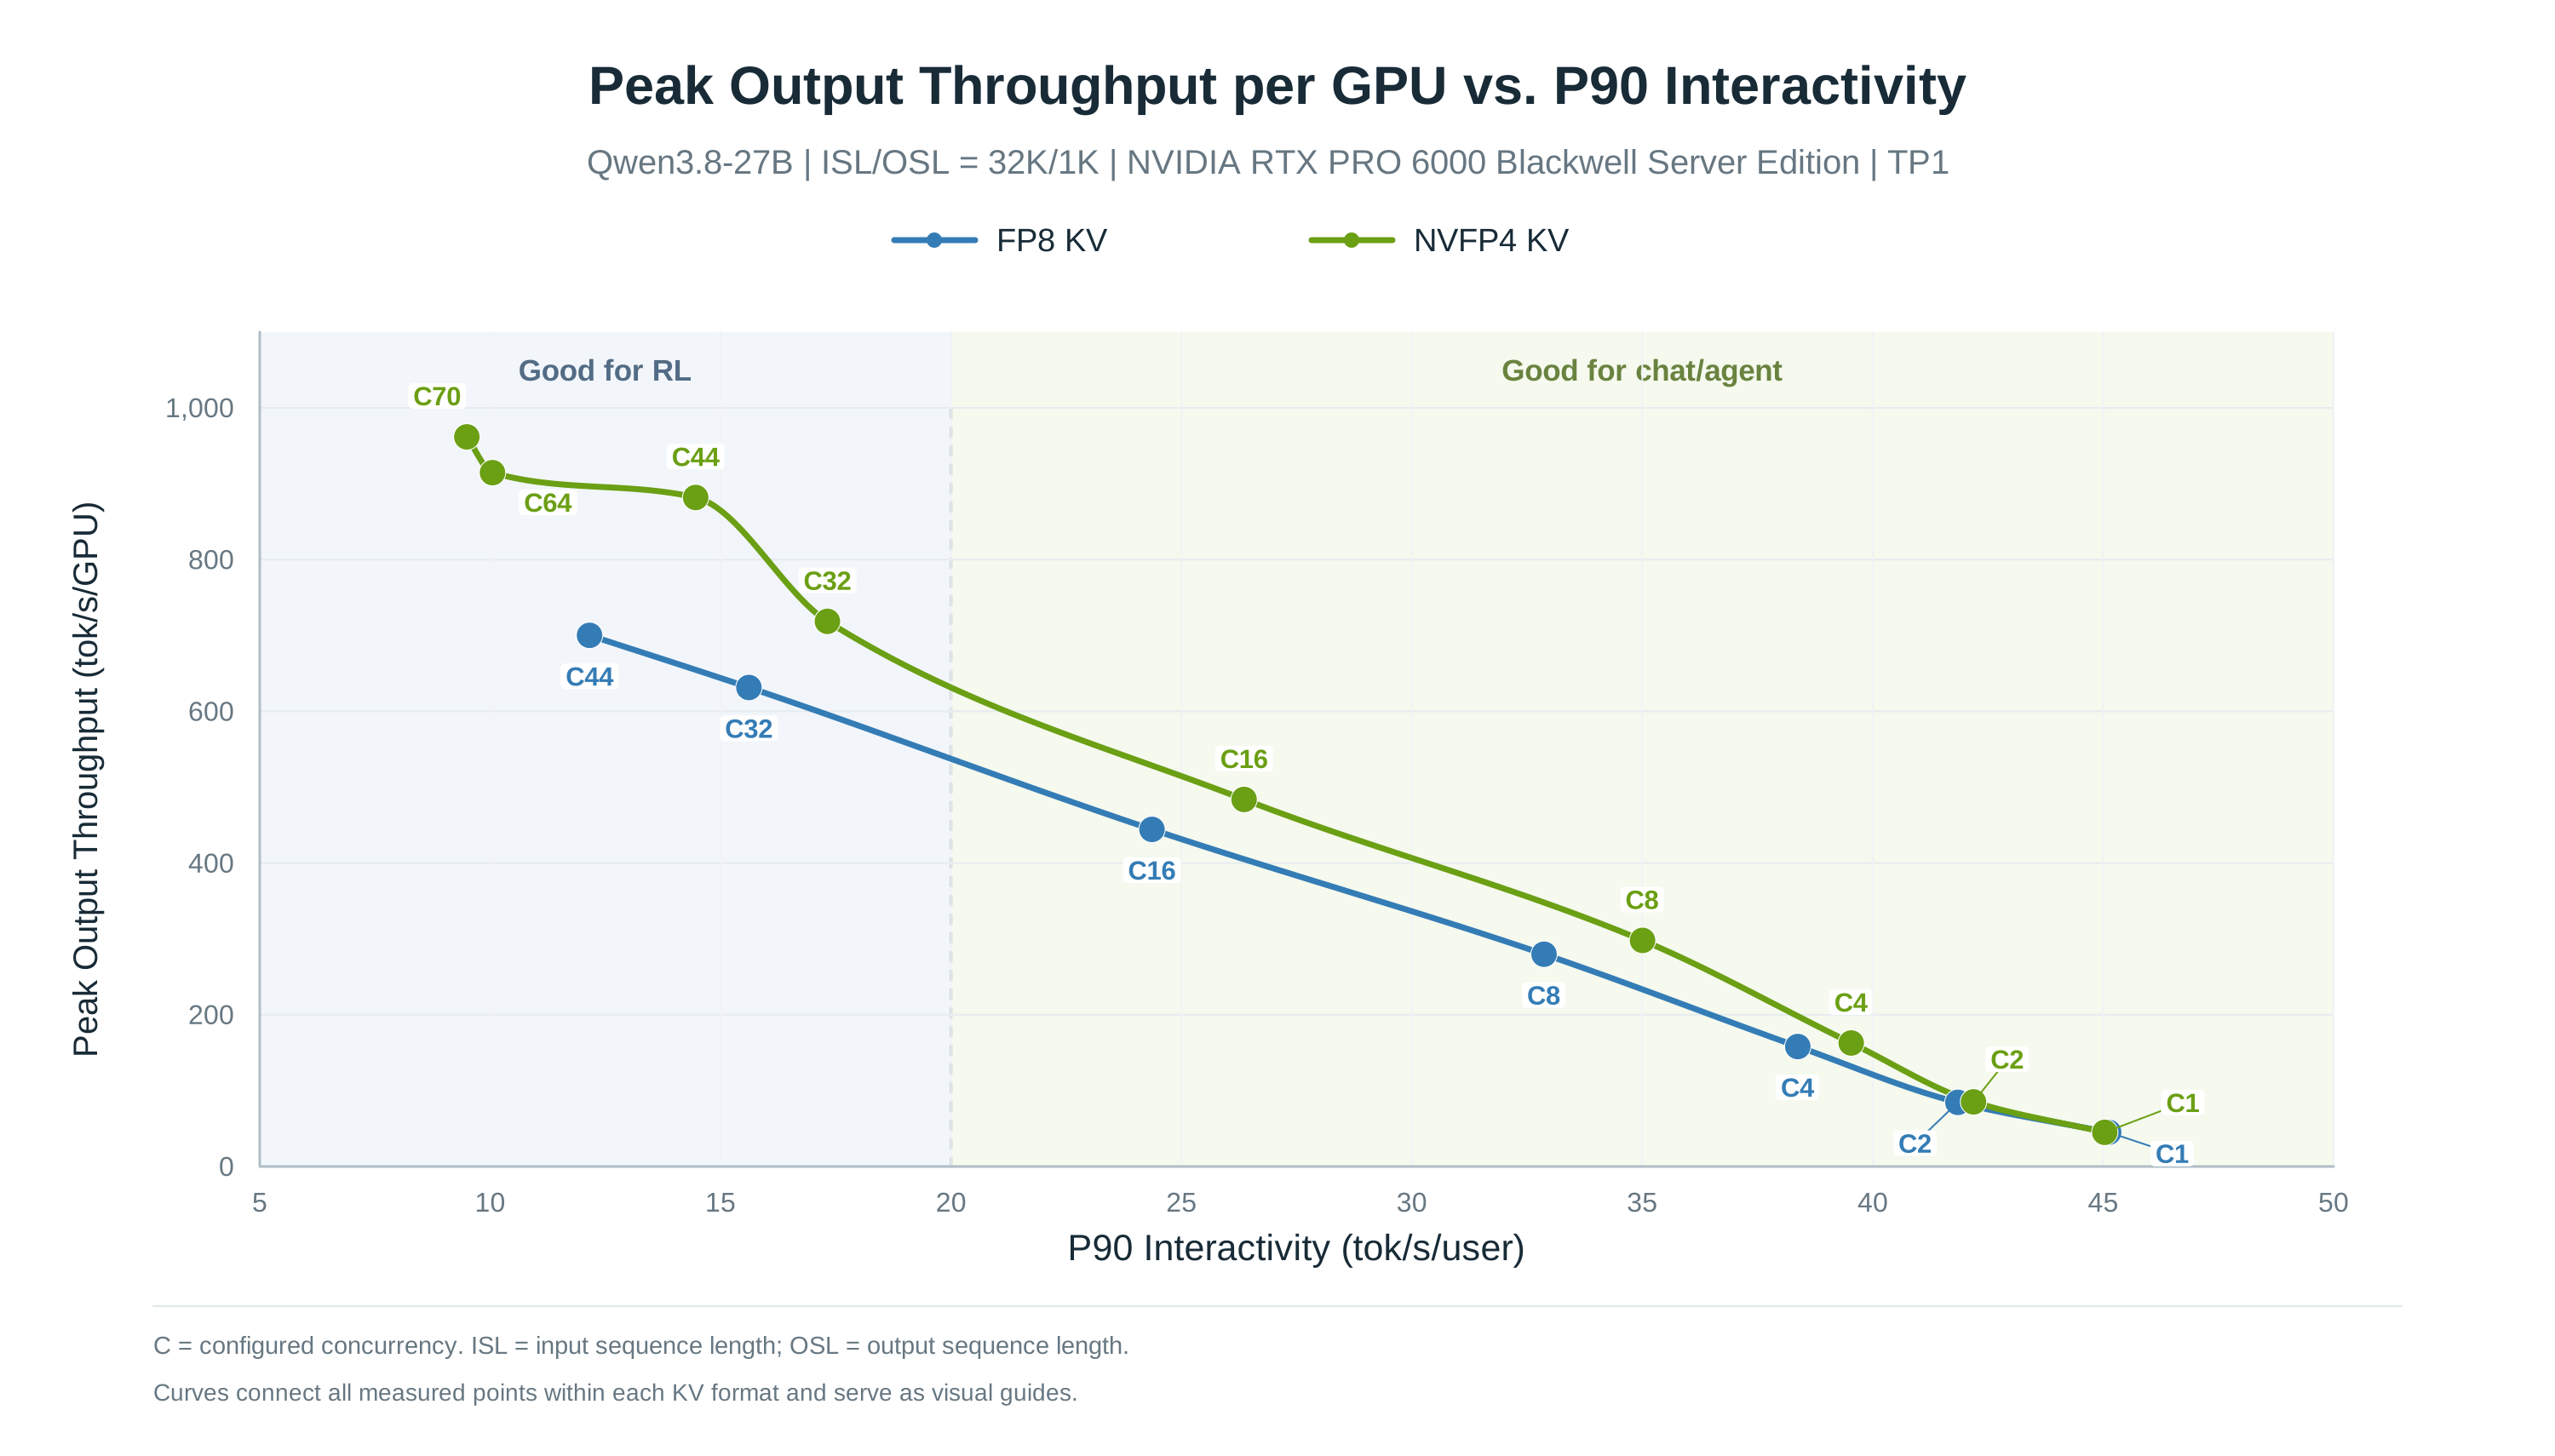
在单张 RTX PRO 6000 Blackwell GPU 上测试,NVFP4 KV 使解码吞吐提升 26-30%,支持更高并发。
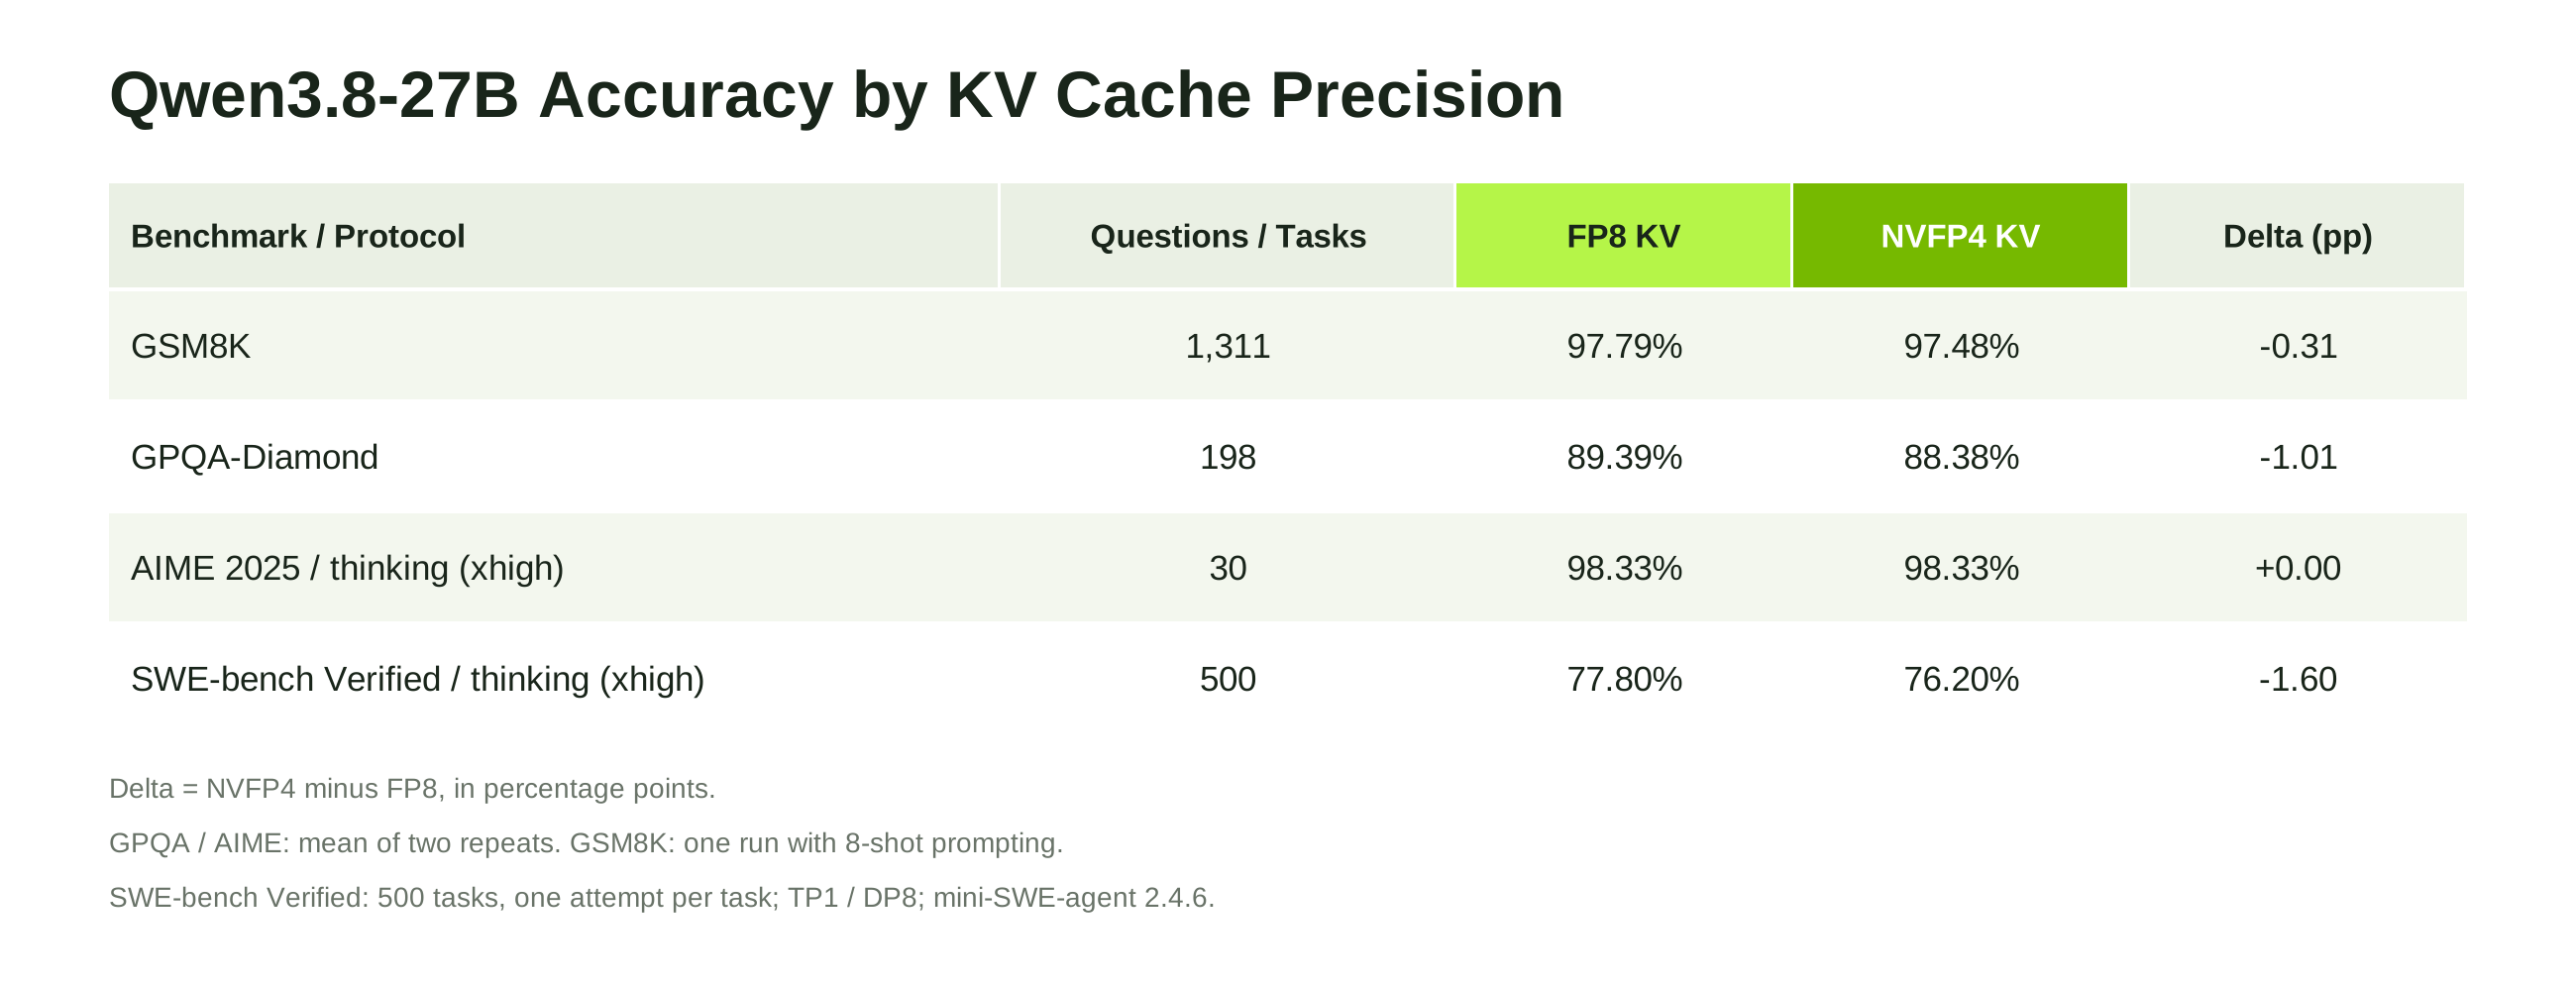
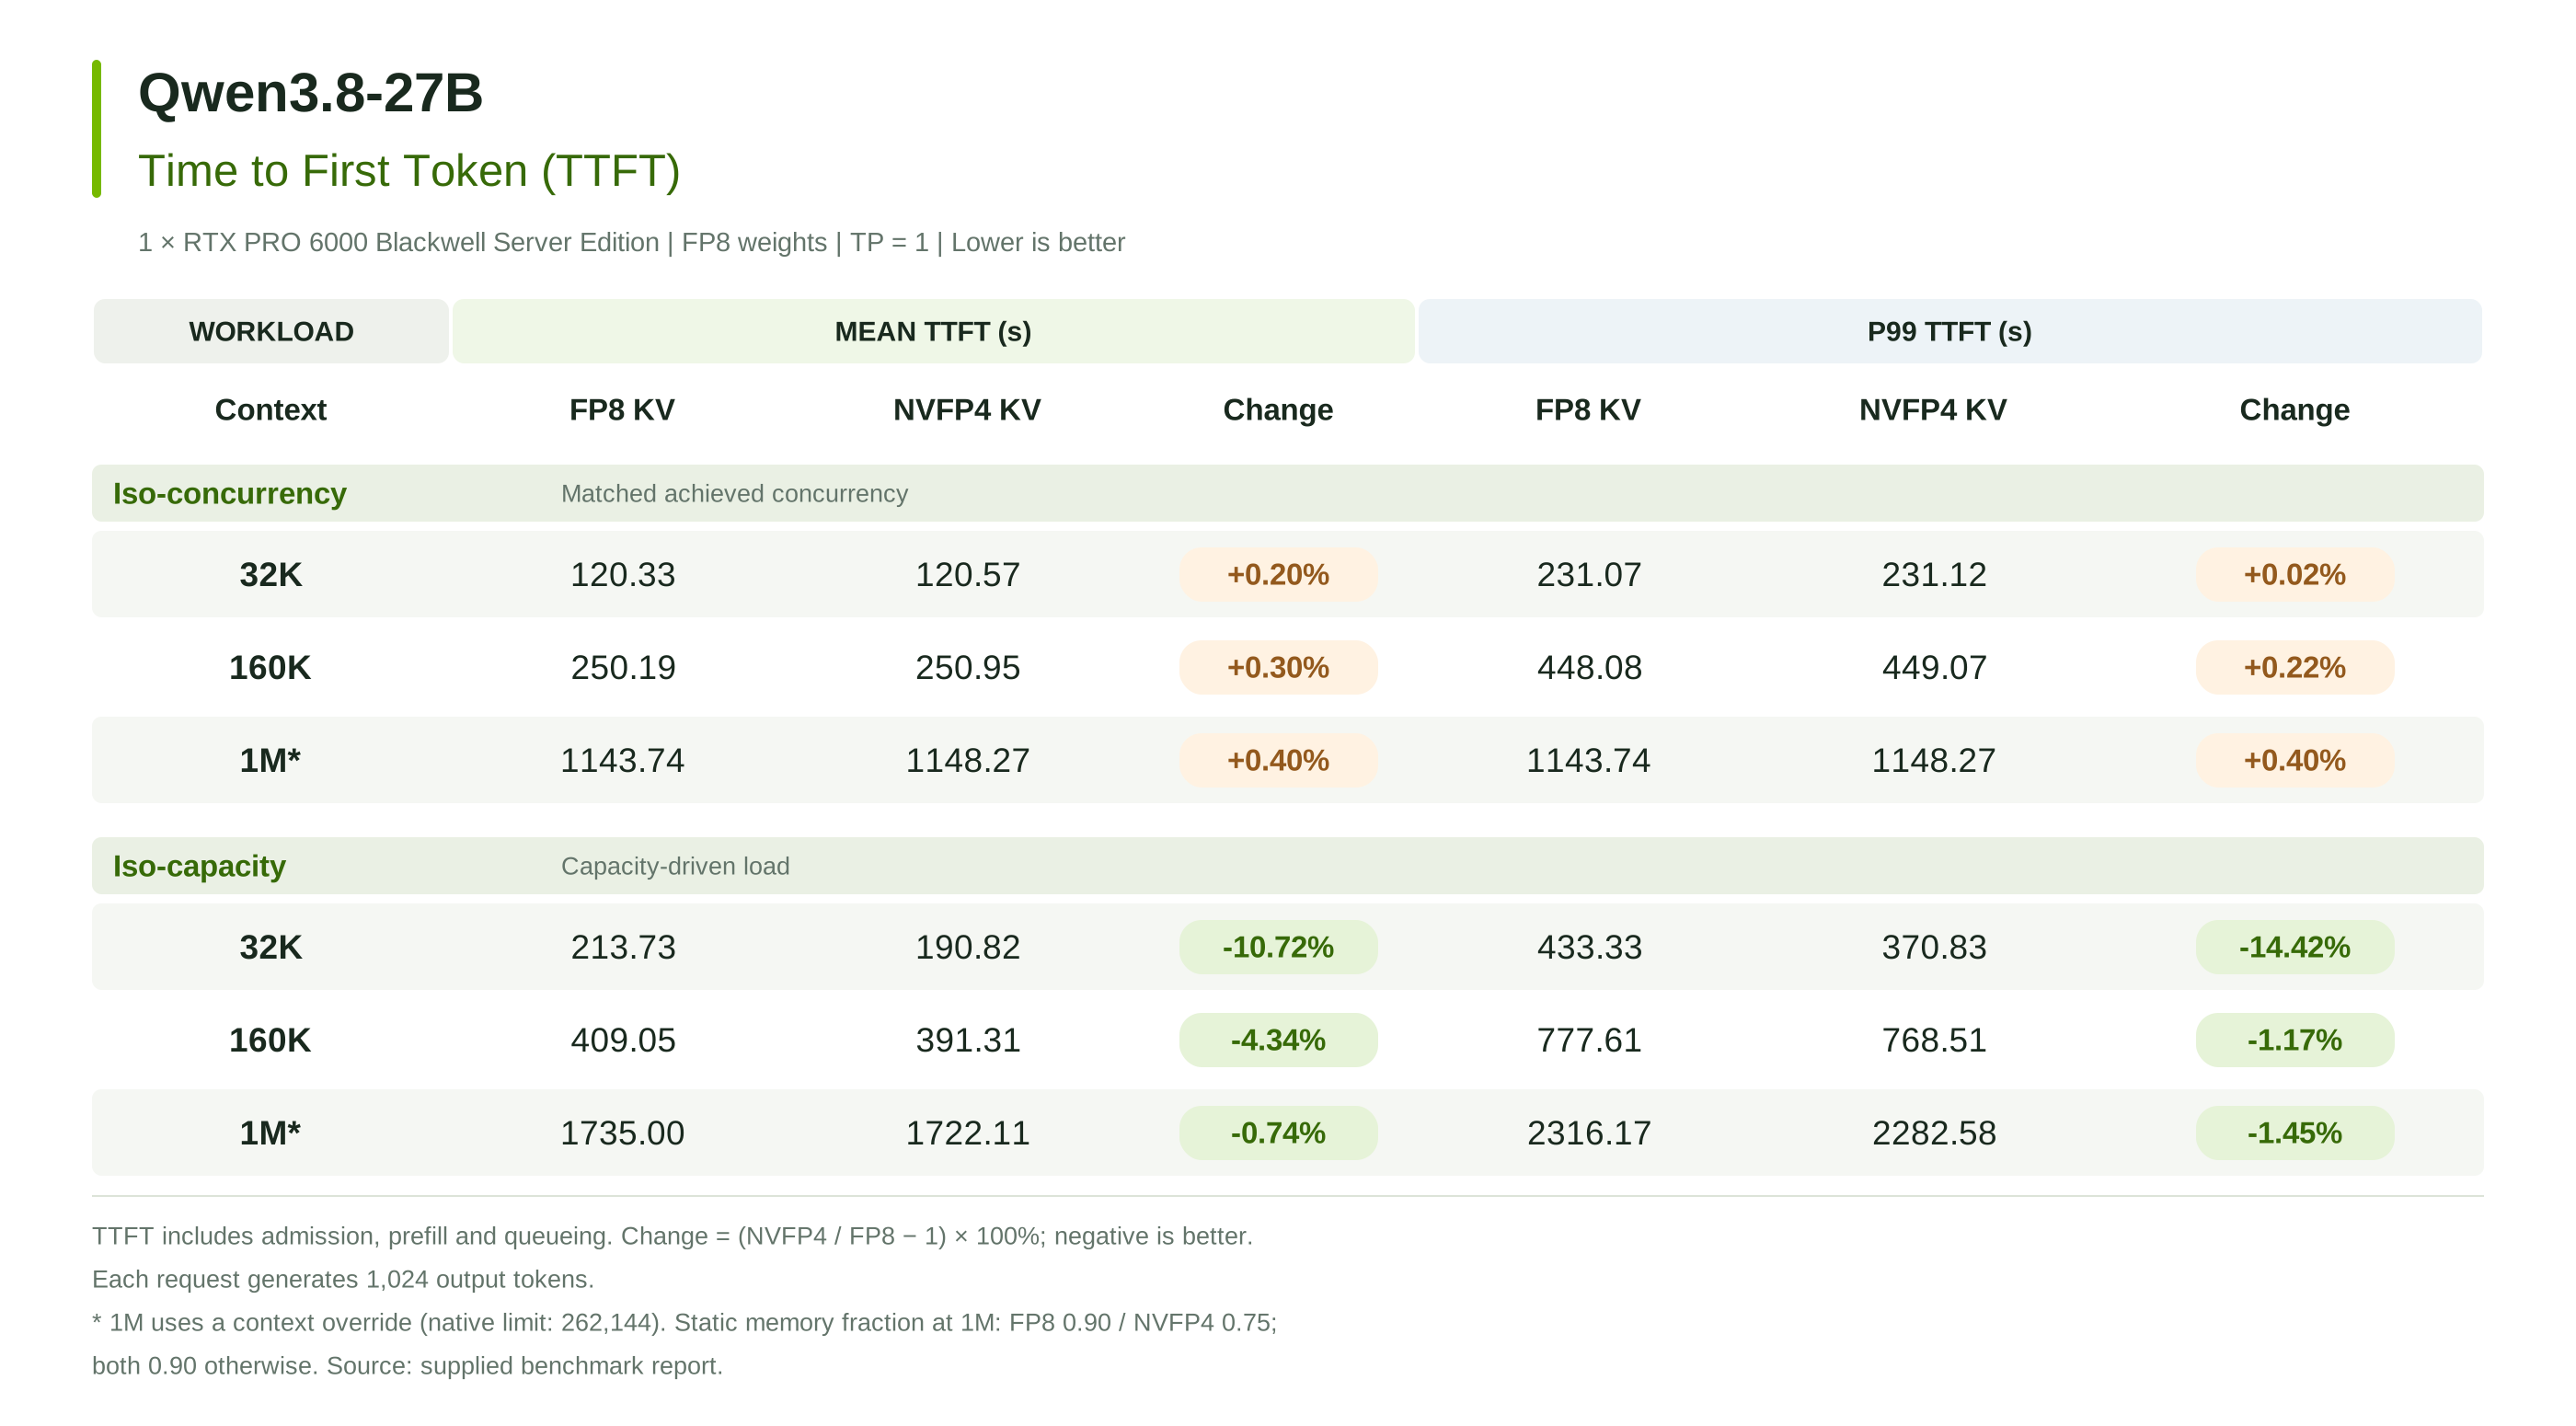
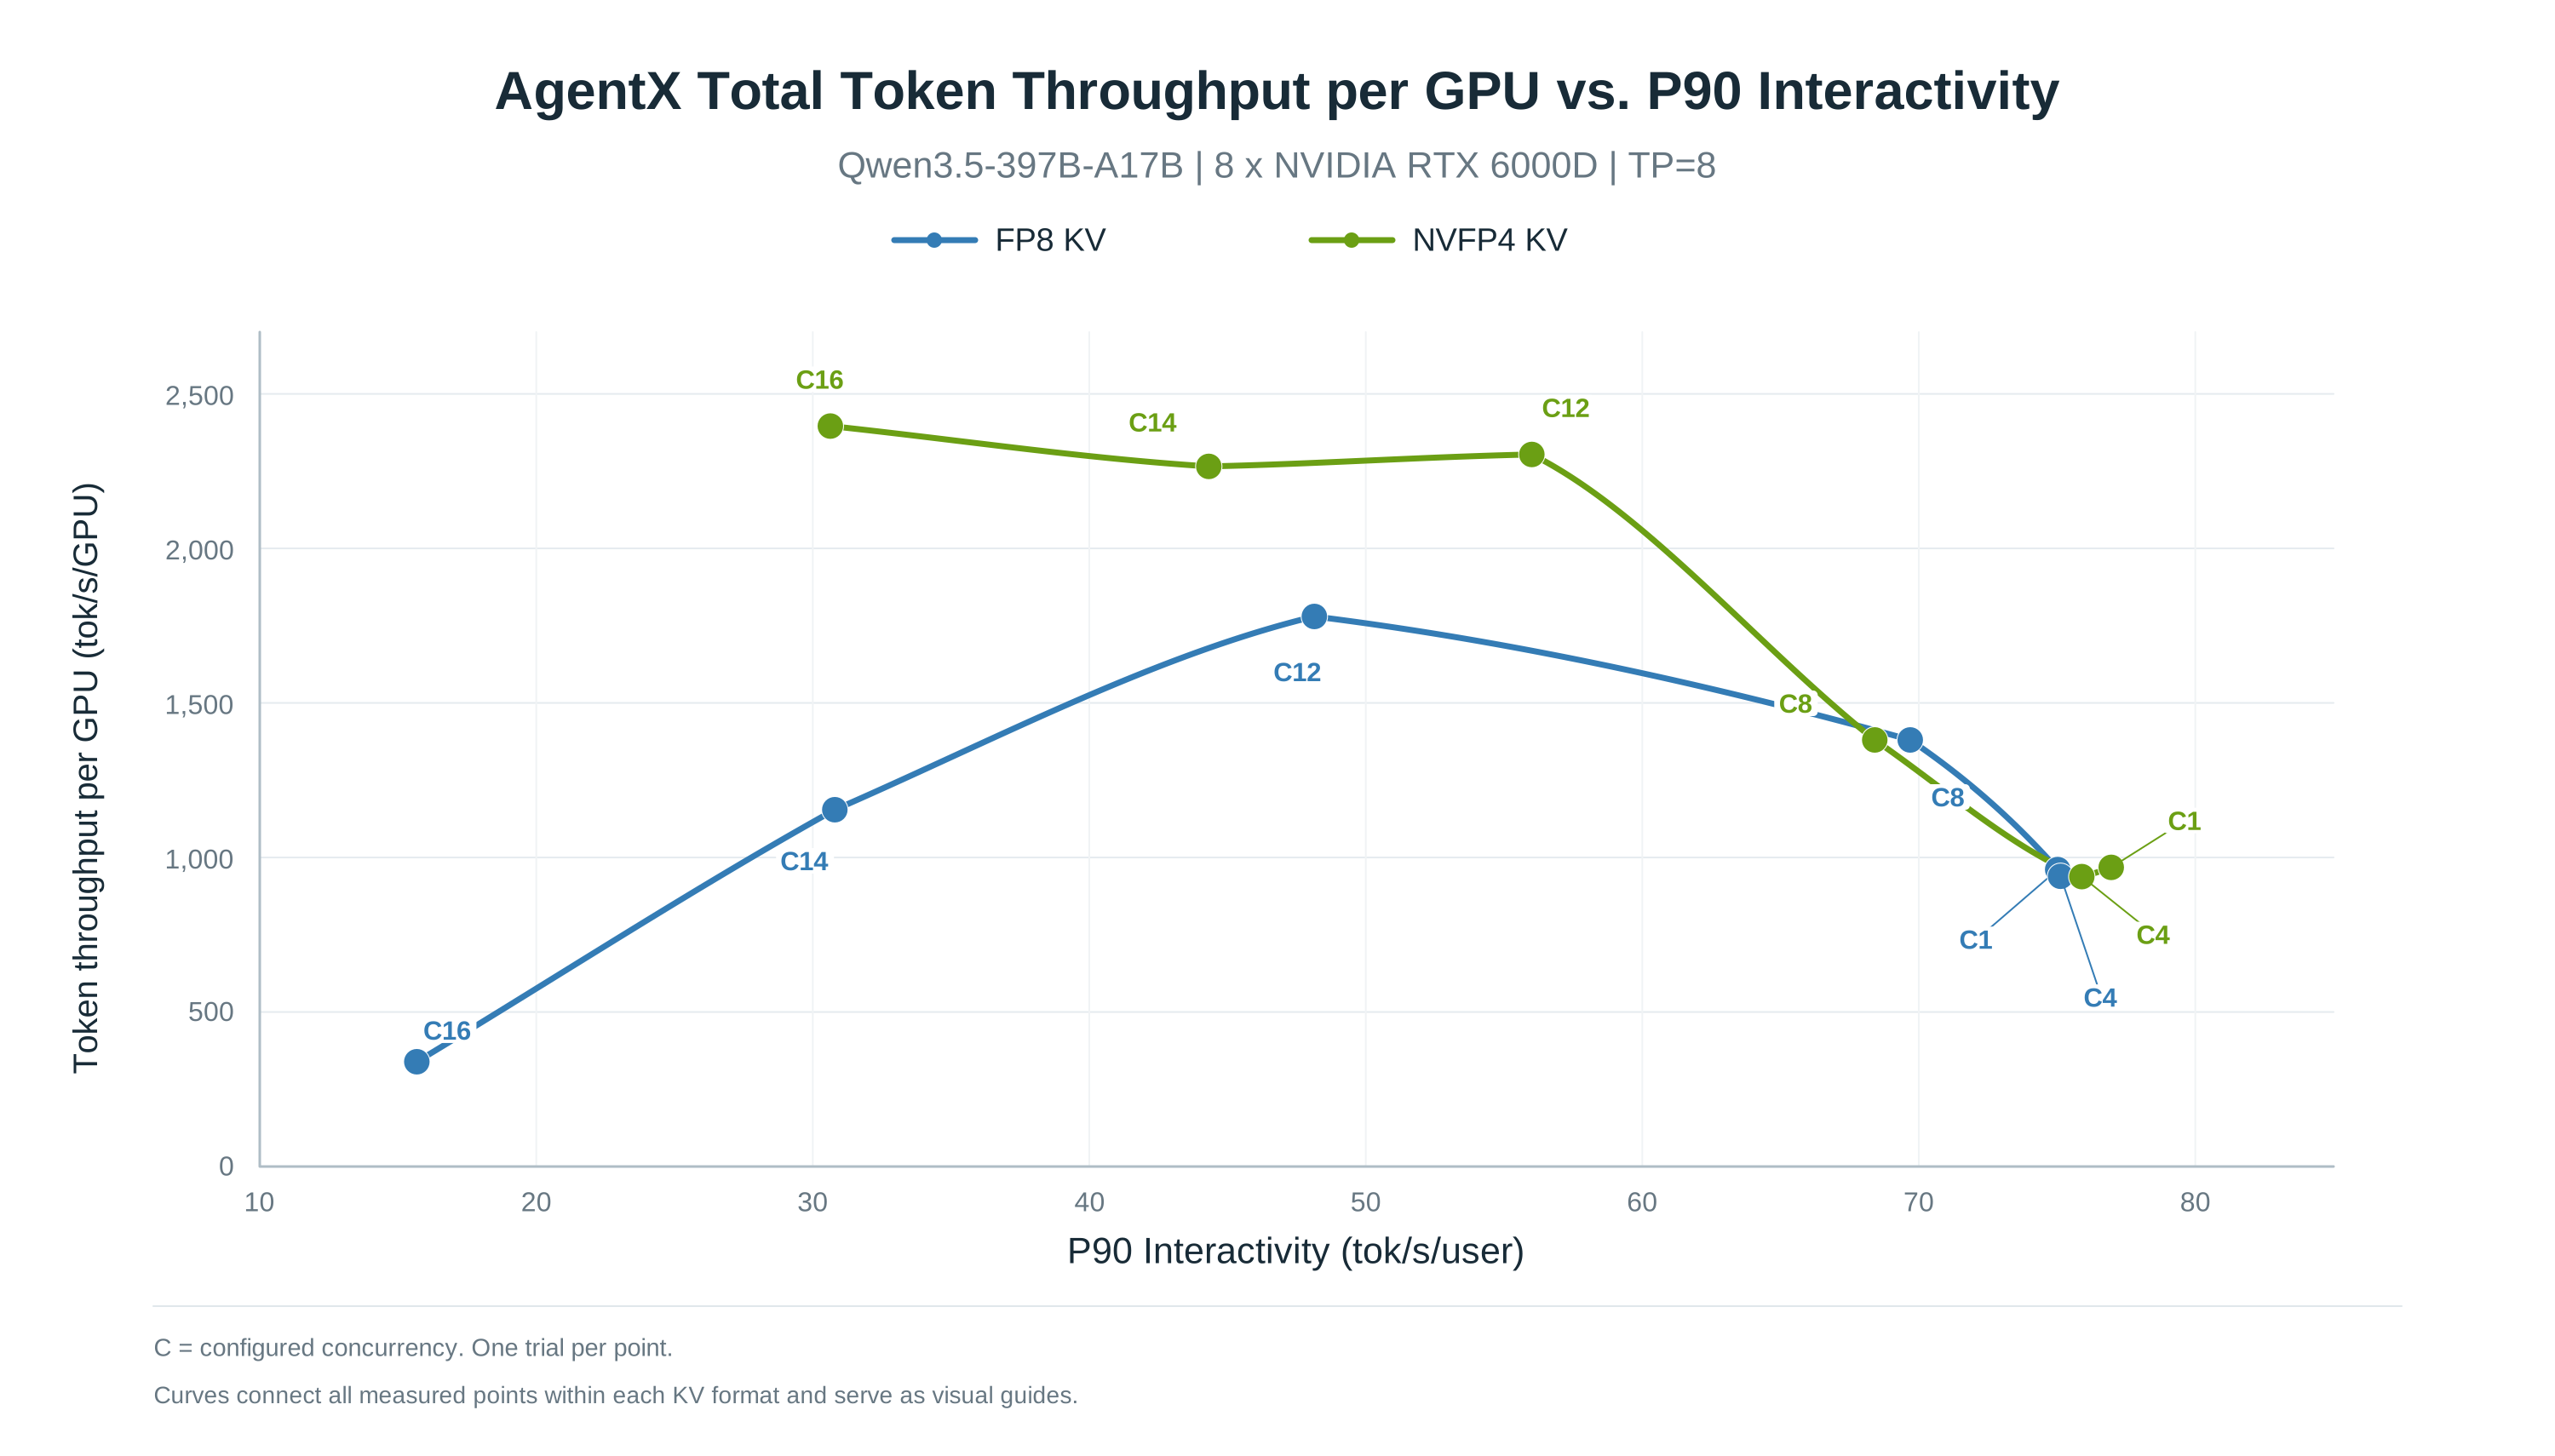
Figure 6. Iso-concurrency decode performance on Qwen3.8-27BFigure 7. Iso-capacity decode performance on Qwen3.8-27BFigure 8. Pareto curve of 32K/1K ISL/OSL on Qwen3.8-27BFigure 9. Prefill performance measured by TTFT on Qwen3.8-27BFigure 10. AgentX performance on Qwen3.5-397B-A17B

结果表明,NVFP4 KV Cache 在保持高精度的同时显著提升长上下文与 Agent 推理效率。

本文来自 LMSYS 博客,赢政天下(winzheng.com)进行了全文翻译。 点击这里查看原文 如果转载中文,请注明出处,谢谢支持!