
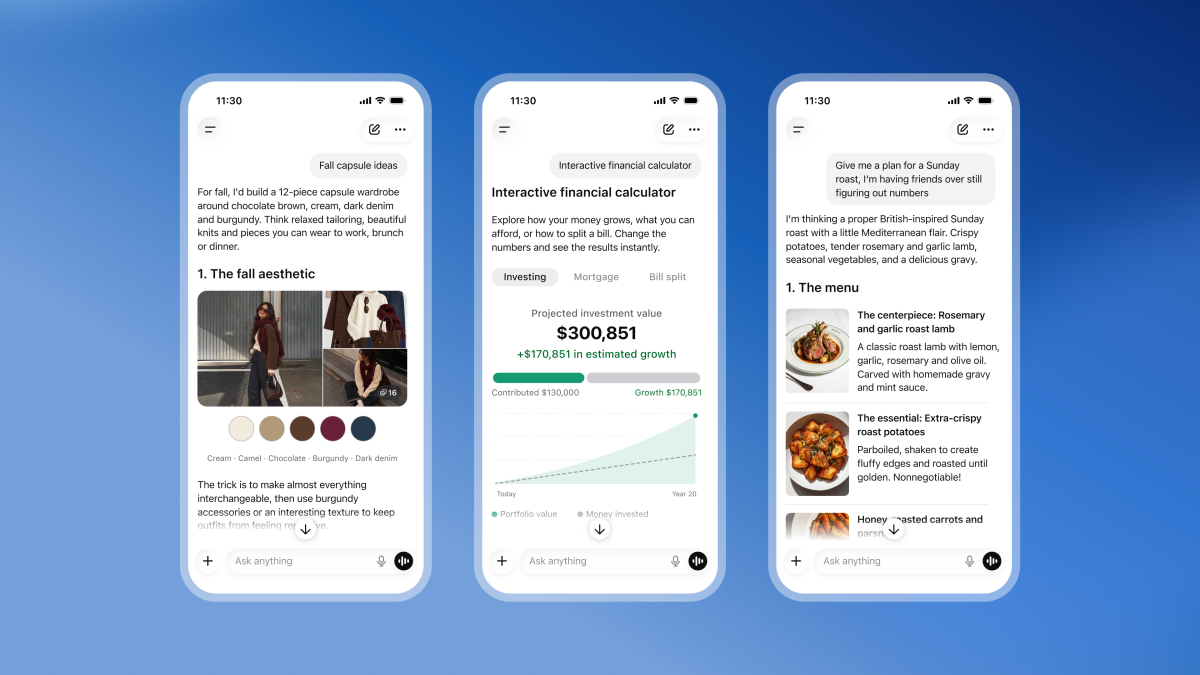
编者按:当聊天机器人不再只是“陪你说话”,而是开始“给你画图、和你互动”,AI助手的形态之争就进入了新阶段。TechCrunch报道OpenAI推出全新视觉化界面,这看似是一次UI更新,实则是多模态竞争的关键落子。
据TechCrunch报道,OpenAI正在为ChatGPT推出一套全新的用户界面,其核心变化是把交互式视觉内容带入对话过程。这意味着,用户与ChatGPT的互动将不再局限于一段段滚动的文字——图表、可点击的卡片、可操作的视觉元素,都有可能直接出现在回答之中。撰稿人Lucas Ropek指出,这次更新让ChatGPT“在视觉上丰富了许多”。
从“读文字”到“看画面”:界面为何重要
过去三年,聊天机器人的竞争主要围绕模型能力展开:谁推理更强、谁上下文更长、谁幻觉更少。但当头部模型的参数规模与基准测试成绩逐渐拉近,用户体验的差距就转移到了“呈现方式”上。同一份数据,用一整段文字解释,和用一张可交互的图表呈现,理解成本天差地别。
全新的界面正是冲着这一点去的。当用户询问财务数据、旅行路线、学习计划或代码结构时,ChatGPT可以用更结构化的视觉形式来回应,而非仅仅输出大段自然语言。这种变化尤其利于教育、数据分析、产品设计等场景——这些领域的用户往往需要“看见”关系,而不仅仅是“读到”描述。
多模态竞争进入“下半场”
这次界面升级并不是孤立事件。近两年,OpenAI、Google、Anthropic等厂商都在把图像、语音、视频等模态不断塞进同一个对话入口。Gemini从诞生之初就打多模态牌,Google的搜索也早已把AI生成的视觉摘要作为默认体验;而OpenAI则从GPT-4时代逐步补上视觉理解与生成能力,如今再把“视觉输出”做成界面层的一等公民。
换句话说,行业的竞争焦点正在从“模型能不能看懂图”,转向“产品能不能把信息以最舒服的方式递给用户”。这是从实验室能力到消费级产品的必经一跃,也是决定用户留存的关键细节。
“OpenAI正在推出一套新的用户界面,它会把交互式视觉内容带给ChatGPT。”——TechCrunch
视觉化不是万能药
当然,可视化也带来新的问题。第一是准确性:文字里的错误容易被读者察觉并质疑,而一张看起来精致专业的图表,可能让错误显得更有说服力。当AI把不准确的数据包装成漂亮的图形,误导性反而会被放大。
第二是性能与延迟。渲染交互式视觉组件比输出纯文本更消耗算力,响应速度可能因此受影响。对于追求“秒回”的对话体验来说,这是一个需要精细权衡的工程问题。
第三是可用性与无障碍。并非所有用户都希望或能够处理视觉信息,屏幕阅读器用户、低带宽环境用户、纯键盘操作者,都需要有顺畅的降级路径。一个真正成熟的界面,应该让视觉成为选项,而不是门槛。
对行业意味着什么
从更宏观的视角看,这次更新释放了一个清晰信号:AI助手的产品形态正在定型为“多模态信息中枢”。它不再只是一个会写字的对话框,而是一个可以解释、演示、组织信息的通用界面层。当界面本身成为差异化优势,后来者要追赶的就不只是模型分数,还有整套交互设计与工程体系。
对普通用户而言,最直观的变化可能是:以后向ChatGPT提问,得到的答案会越来越像一份精心排版的简报,而不是一封长长的回信。这种体验是否更好,最终取决于OpenAI能否在“信息密度”和“认知负担”之间找到平衡点。
界面只是外壳,但它决定了用户愿不愿意留下来。这一次,OpenAI显然想让ChatGPT不只是“说出来”,还要“show出来”。
本文编译自TechCrunch
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接