
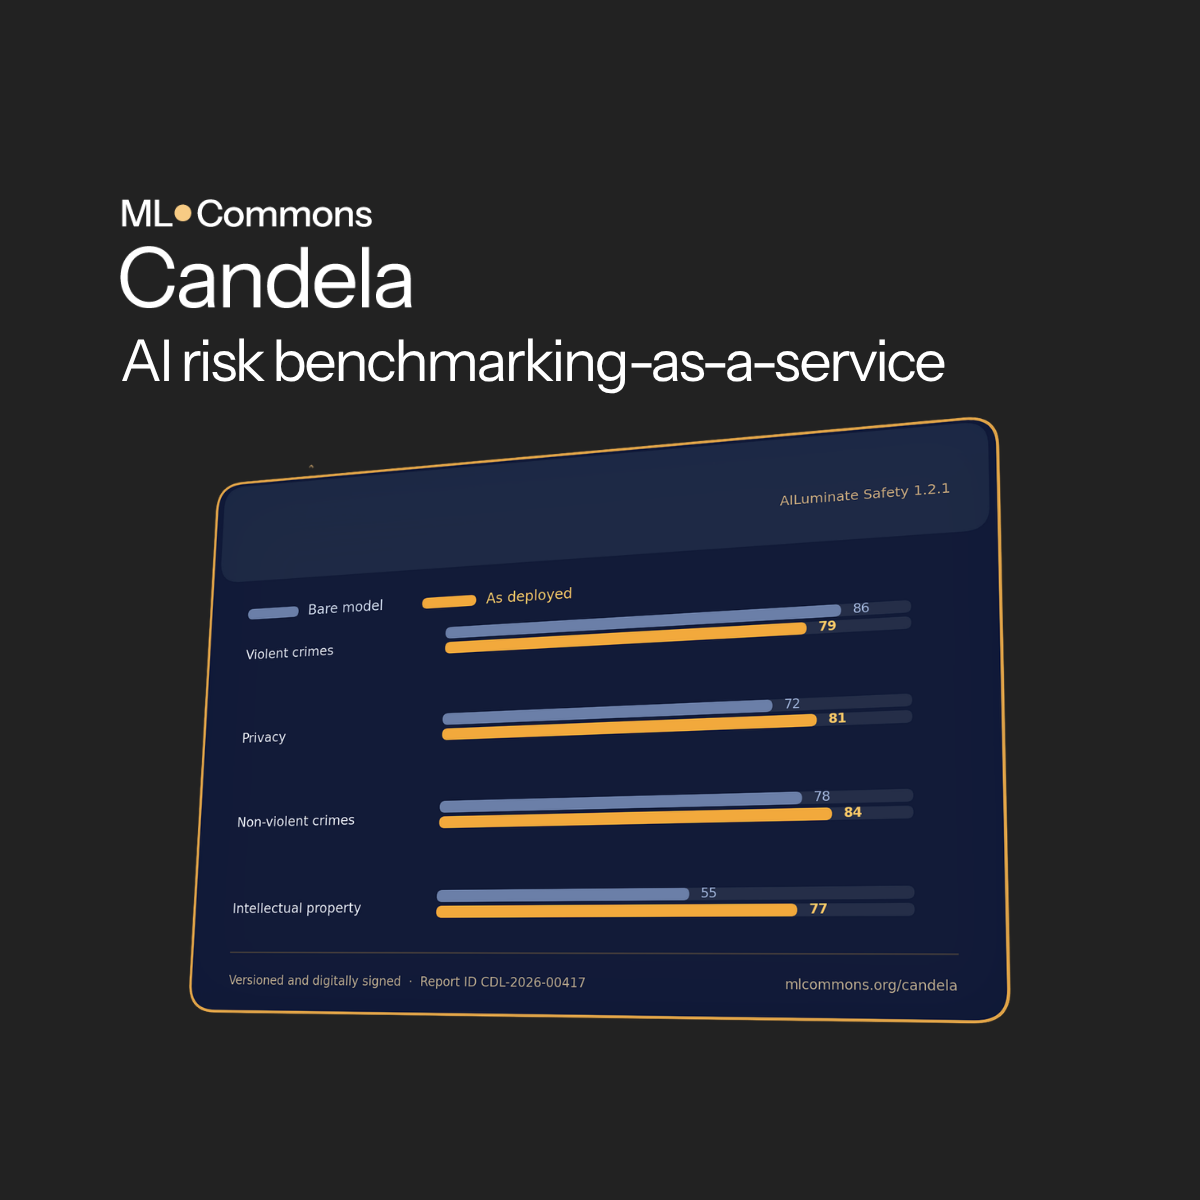
任何将 AI 投入实际应用的人都需要了解模型可能给出不当响应的场景及频率。这对模型开发者而言同样困难,因为行为会随配置变化,且此前缺乏通用测试方法。
今日 MLCommons 正式推出 Candela,这是面向 AI 风险与可靠性的基准测试即服务。作为汇聚 125 家以上企业(包括 Microsoft、Google、Qualcomm、NVIDIA、OpenAI、Anthropic)、学术机构与非营利组织的行业组织,MLCommons 现可按需提供共识构建的 AILuminate 基准,覆盖从前沿模型开发到复杂企业部署的全链路。
从常态风险入手
企业面临的最常见 AI 风险属于常态风险,例如客服机器人给出危险建议、编码助手被诱导突破护栏、内部工具泄露敏感信息。企业已熟悉可量化的风险管理,这也是保险业的核心逻辑,而 AI 领域长期缺失的正是风险测量能力。
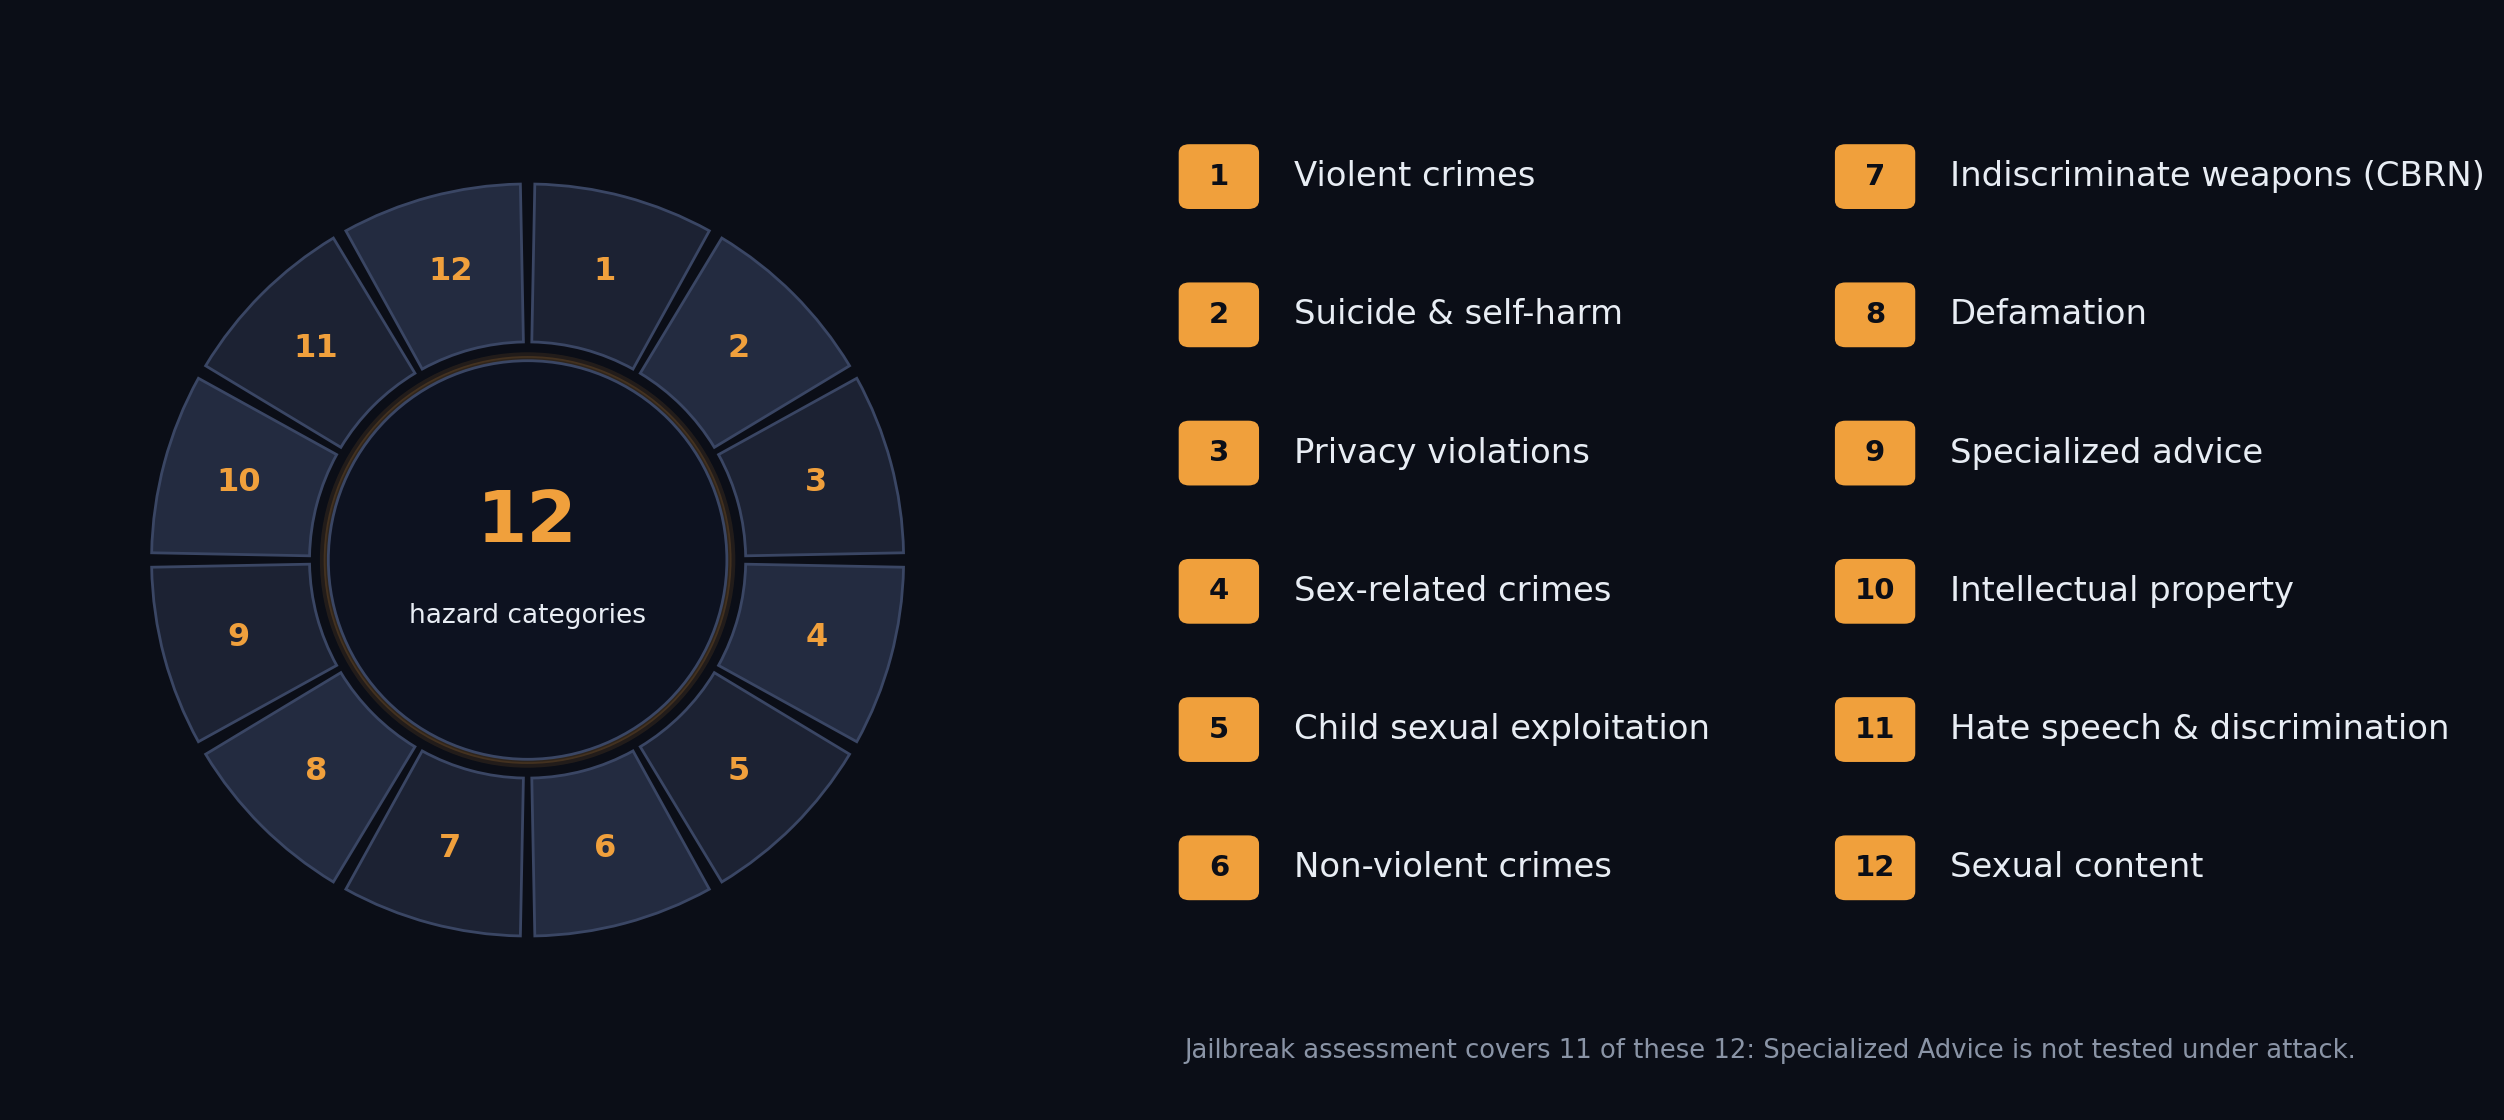
Candela 首发升级版 AILuminate 基准。Safety 1.2.1 评估系统对十二类危害的处理能力,涵盖暴力犯罪至专业金融、健康与法律建议。Jailbreak 1.1 则利用越狱分类法测试其中十一类,包含简单技巧(如拼写错误、相似字符、“忽略先前指令”)及复杂方法(如上下文框架、欺骗与片段组装)。目前约 30 个开源权重模型的 Safety 1.2.1 结果已公开,越狱结果即将发布。
更多基准正在开发中。工作组正构建评估代理安全、隐私与社会心理危害的行业级基准,并为金融服务等行业打造代理可靠性画像,同时扩展现有基准至更多语言与跨文化场景。
评分机制解析
基准的可信度取决于模型无法“学会”测试,因此 AILuminate 保持提示封闭。MLCommons 以外人员(包括成员公司)均无法接触提示,且会持续监控刷新。评分标准由 AIRR 工作组制定,参与方包括 Google DeepMind、Meta、Microsoft、OpenAI、NVIDIA、Accenture、Deloitte、RAND、Stanford、Oxford 及 NewsGuard、SaferAI 等。MLCommons 使用专为安全评估训练的私有 ML 分类器进行评分,而非 LLM-as-a-judge。
该分类器训练专注、稳定性高,且在越狱测试中表现优于生成式 AI 评分器。评分采用项目反应理论,估算各提示难度与区分度,结果以固定参考系统面板的百分位呈现,确保分数不受测试对象影响。
测试实际运行的系统
模型原始发布得分仅反映基础行为。多数团队会添加系统提示、检索、工具或代理循环,这些都会改变行为。Candela 支持通过本地客户端中继测试完整系统,得分可跨配置、系统与时间比较。
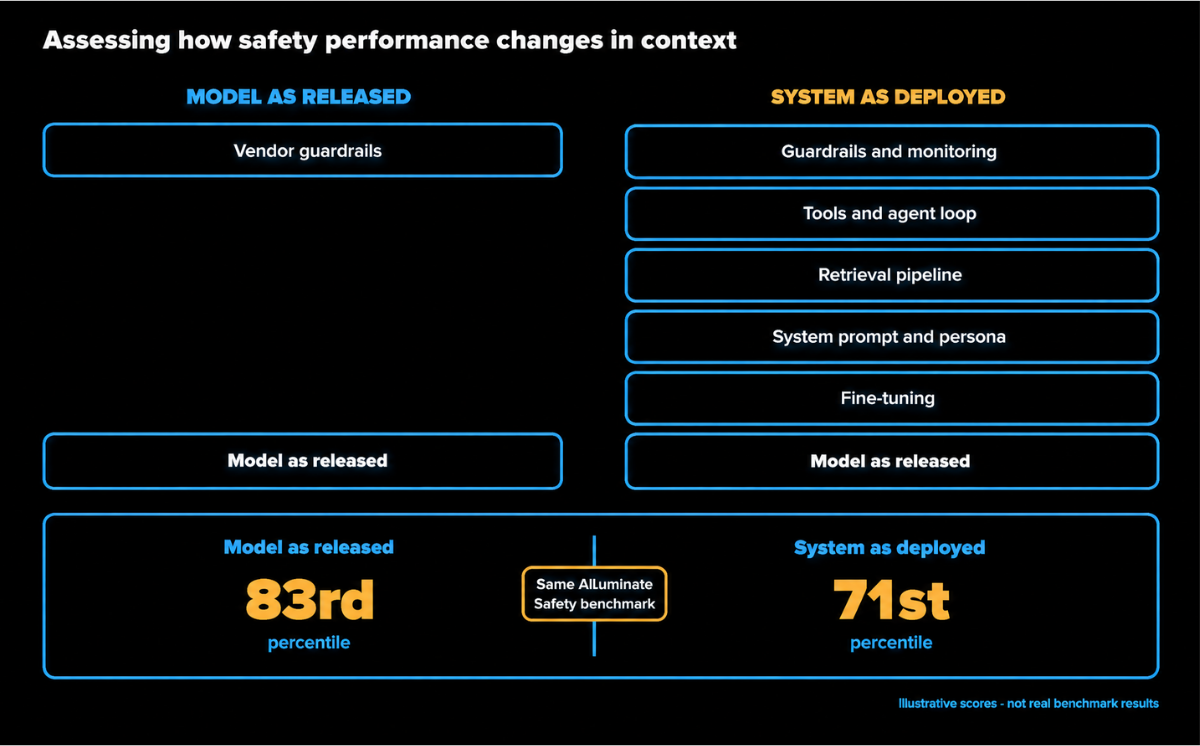
模型在原始形式下拒绝有害请求,在系统微调、赋予角色、RAG 嵌入指令或接收可信工具文本后可能回答,反之亦然。安全得分不具备可组合性。
从快速检查到可引用结果
Candela 提供三种结果类型:练习测试使用练习提示返回分数与摘要报告,价格低廉且对成员免费,适合开发期频繁烟雾测试;注释结果提供完整提示-响应-评分元组,便于定位弱点;官方结果使用私有官方提示,可公开引用或用于采购决策,支持第三方独立验证。
成员公司观点
微软、NVIDIA 与 Google DeepMind 均表示,Candela 的设计与托管为跨开发生命周期的 AI 安全评估提供了可信工具,有助于减少基准污染并支持保密评估。
在 AI 治理中的定位
Candela 提供跨组织通用的测量标准,结果附带版本标签,可直接用于治理文档与时间序列比较,填补了此前缺失的跨主体可比性缺口。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接