
如果你刚接触AI基础设施,可能还不熟悉MLCommons——这个开源工程联盟是全球AI性能测量的权威标准制定者。此前MLPerf基准主要测试孤立硅片性能,而最新发布的MLPerf Endpoints v1.0则聚焦更大系统:它在类生产负载下测量实时API端点表现。
该基准评估的是完整AI技术栈——硬件、模型、服务软件、批处理行为与网络的综合表现,而非真空中的调优加速器,为买家和系统构建者提供真实世界能力的直观洞察。
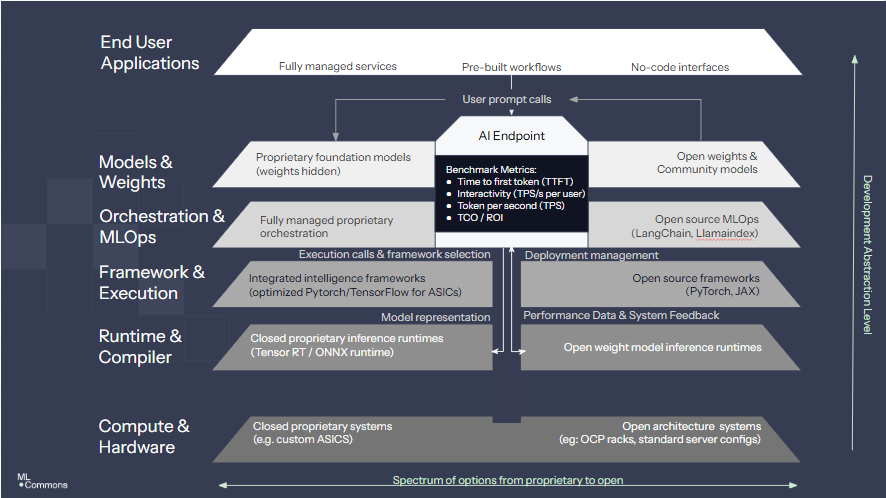
为什么MLPerf Endpoints v1.0对提供商和系统构建者至关重要
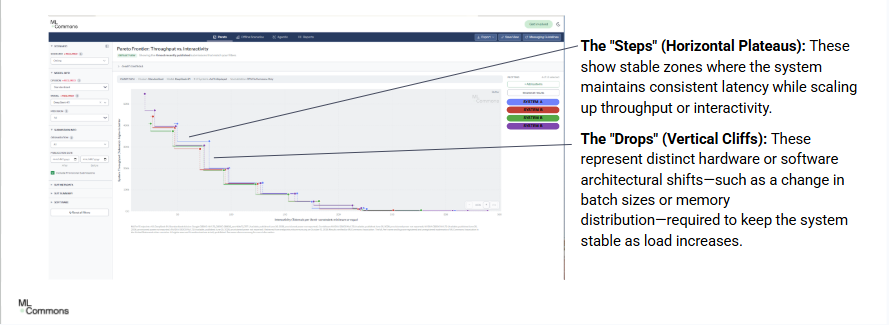
对云提供商、硬件OEM、管理服务商和“新云”而言,现有AI基准往往演变为调优竞赛,无法反映实际业务价值。MLPerf Endpoints v1.0通过生成完整Pareto前沿,展示系统在不同工作负载下的真实行为,而非单一峰值分数。它仅使用实测数据,不进行估算或插值,清晰揭示客户可能遇到的性能断崖。
企业合法性与全栈创新展示
提交系统可获得行业竞争对手与第三方审计的严格同行评审背书,赋予工程、销售和营销团队无可争议的权威性。若你开发了突破性自定义调度器或优化了网络结构,传统基准可能忽略这些创新,而Endpoints会完整测量整个前沿数据集,让软件与集成工程成果得以彰显。
真实工作负载画像
v1.0套件不使用人工或合成测试,而是采用客户今日实际使用的负载,从简单单次任务扩展至复杂多轮AI Agent。任务家族包括:Summarization(Llama 3.1 8B Instruct等)、Reasoning(DeepSeek-R1)和Agentic Coding(Qwen 3.6等多模型多轮轨迹)。
提交MLPerf Endpoints v1.0的流程
该基准大幅降低工程开销,支持滚动提交,每几周形成发布队列。具体步骤包括:签署CLA获取PRISM API密钥、安装参考客户端、规划Pareto前沿(Agentic需7个测量点,非Agentic需8-32个)、运行inference-endpoint工具采集吞吐与TTFT P90等指标、编写system_desc.json与system_power.json披露文件、本地验证合规性、最终提交生成同行评审PR。
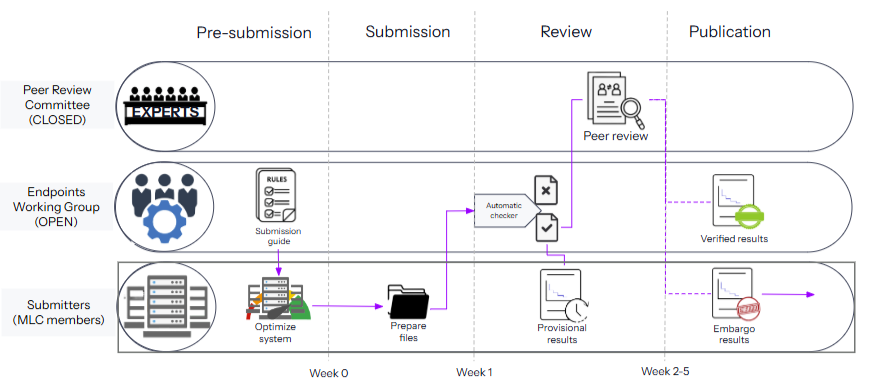
提交后结果进入持续同行评审,最终生成直观的MLPerf LoadStair可视化图。MLPerf还允许自动检查后分享临时结果,最终验证结果可按需设置发布禁运。更多详情请参阅官方首次提交者指南。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接