
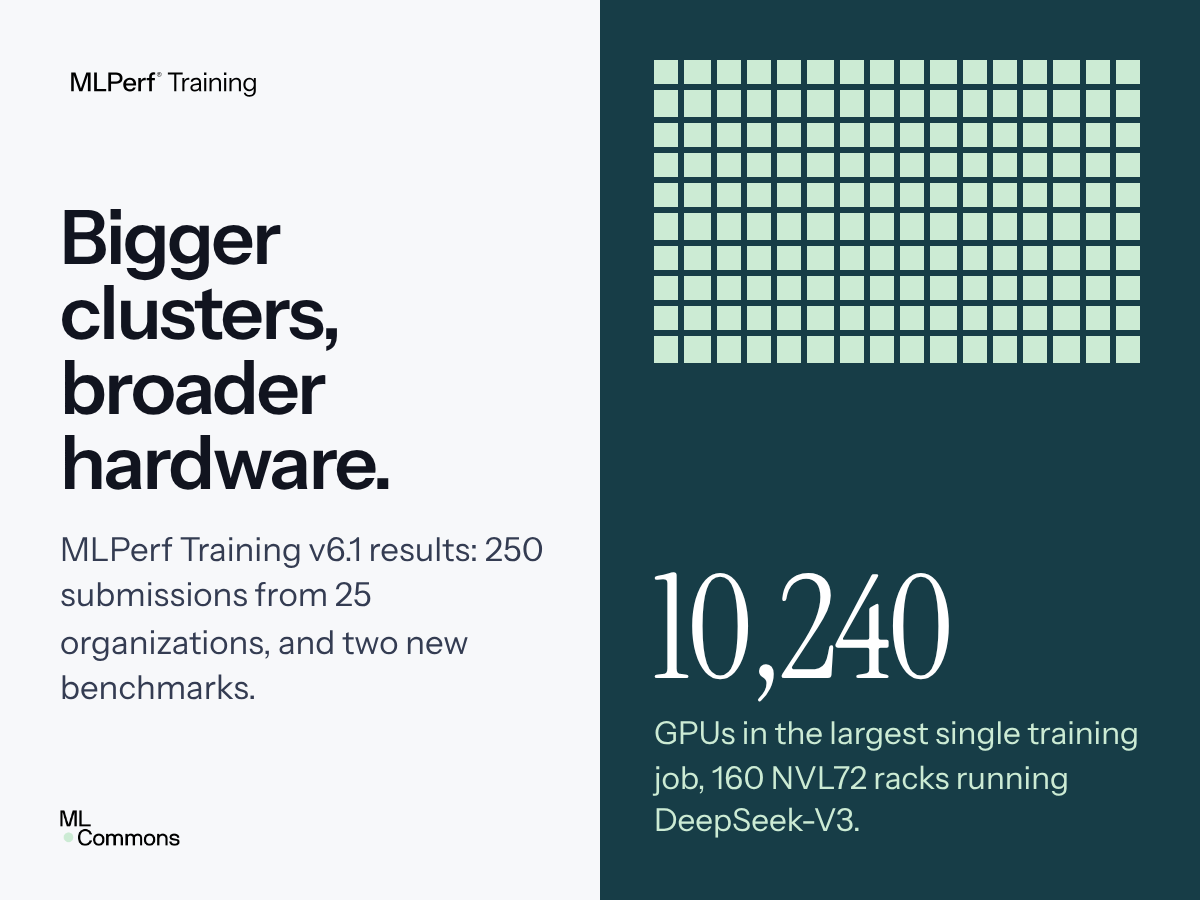
本轮概览
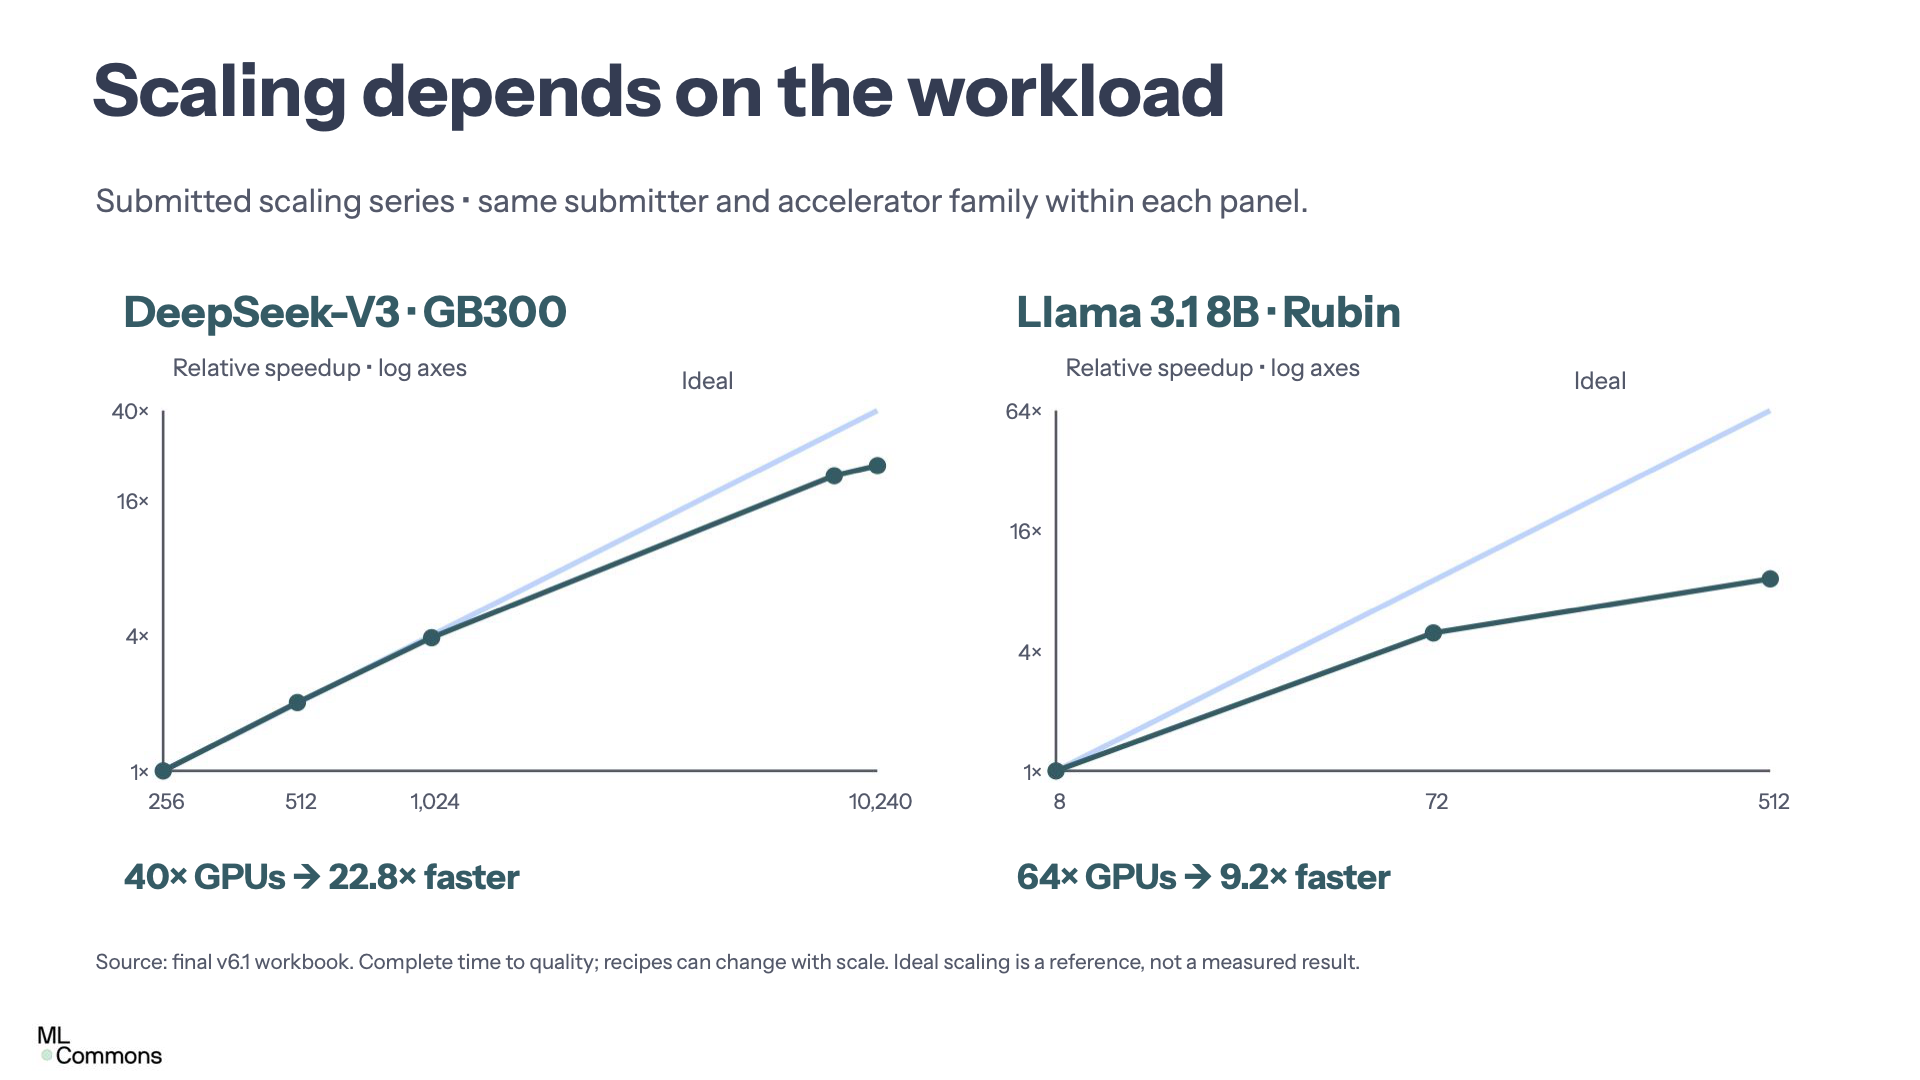
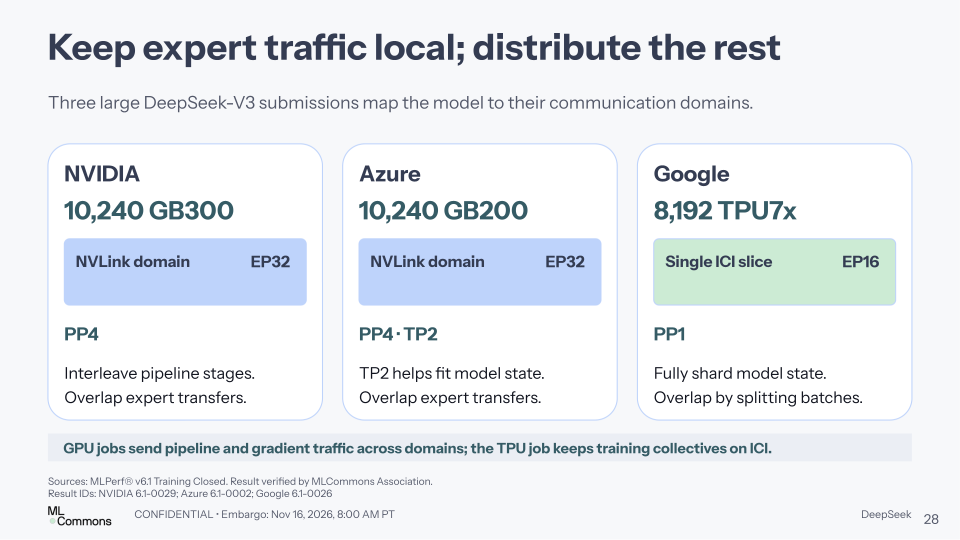
MLPerf Training v6.1扩展了基准套件,并展现成员提交的更大规模系统。新增两项基准:Qwen3.5-397B GRPO用于代理强化学习,DLRMv4-HSTU为生成式推荐模型。Google Ironwood与NVIDIA Rubin作为可用系统首次亮相。最大作业规模达到10240 GPU(NVIDIA GB300与Azure GB200,均训练DeepSeek-V3),多节点系统占比升至76%,硬件组合扩展至12款加速器与四种扩展互联技术。
本轮共收到25家提交者的250份提交,高于v6.0的229份。
AI训练性能超越摩尔定律
MLPerf Training性能指数的几何平均增速远超每两年翻倍的摩尔定律假设。从v0.6到v6.1,累计性能提升显著,尤其在FLUX.1等任务上表现突出。
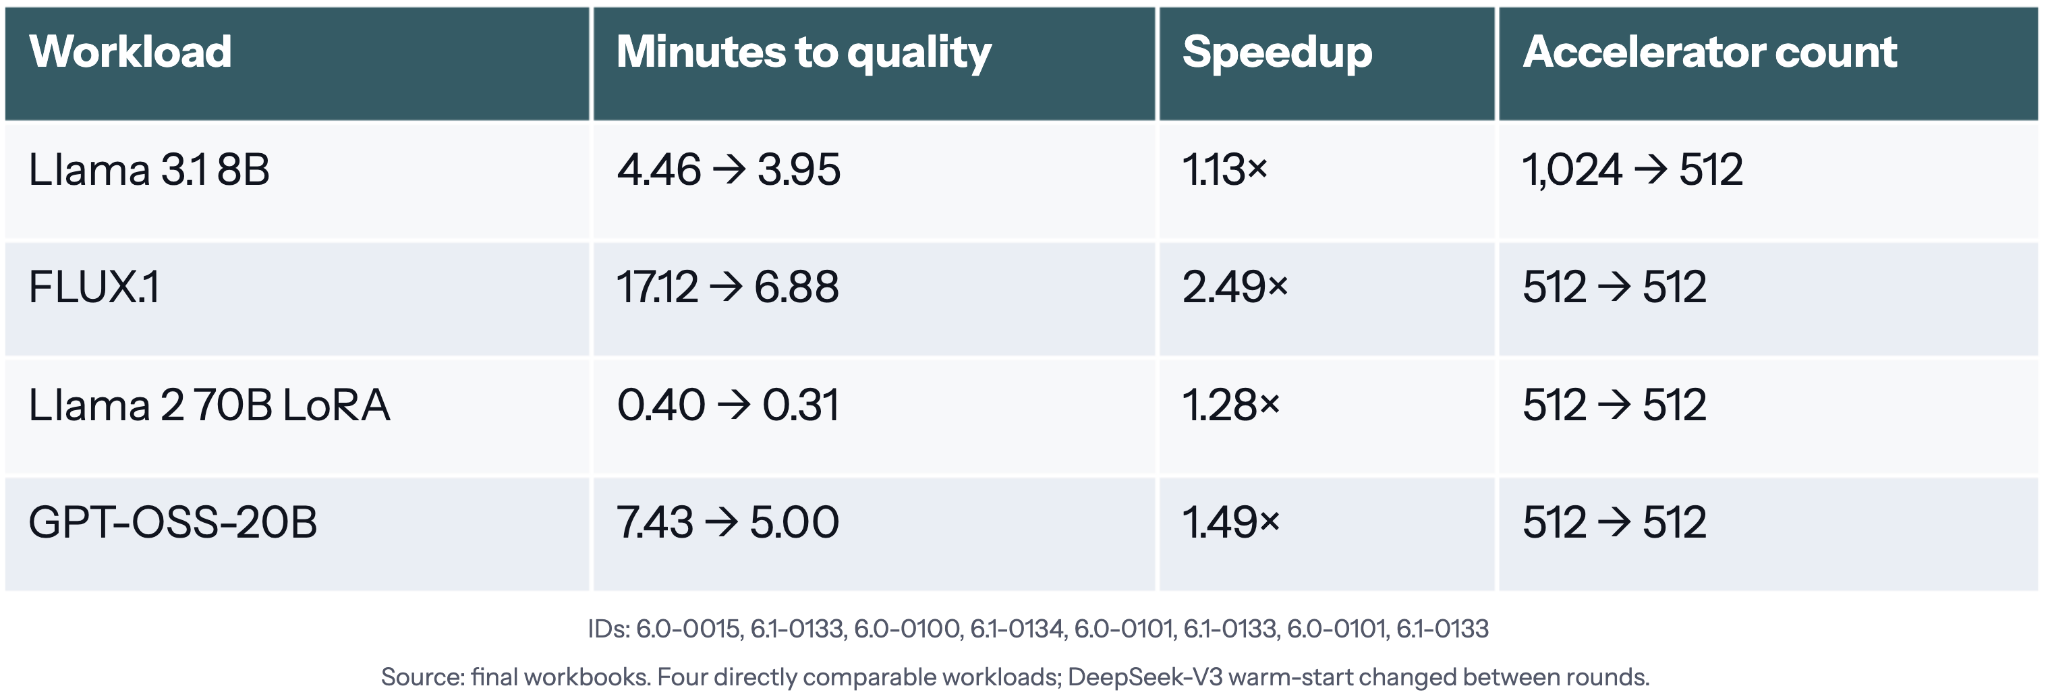
可比基准性能对比
四个延续基准中,相同规模系统(128节点、512加速器)在v6.1展现明显加速,FLUX.1提升尤为迅猛。
基准更新
新增Qwen3.5-397B GRPO(7家提交者、29份结果)和DLRMv4-HSTU(8家提交者、20份结果)。同时退役Llama 3.1 405B与DLRM-DCNv2,转向MoE模型与新一代推荐任务。
提交者构成与目的
芯片厂商聚焦新硅首秀,服务器厂商展示多配置选择,云服务商验证生产环境竞争力,学术机构在共享集群上完成提交,软件优化与能耗测量亦有亮点。
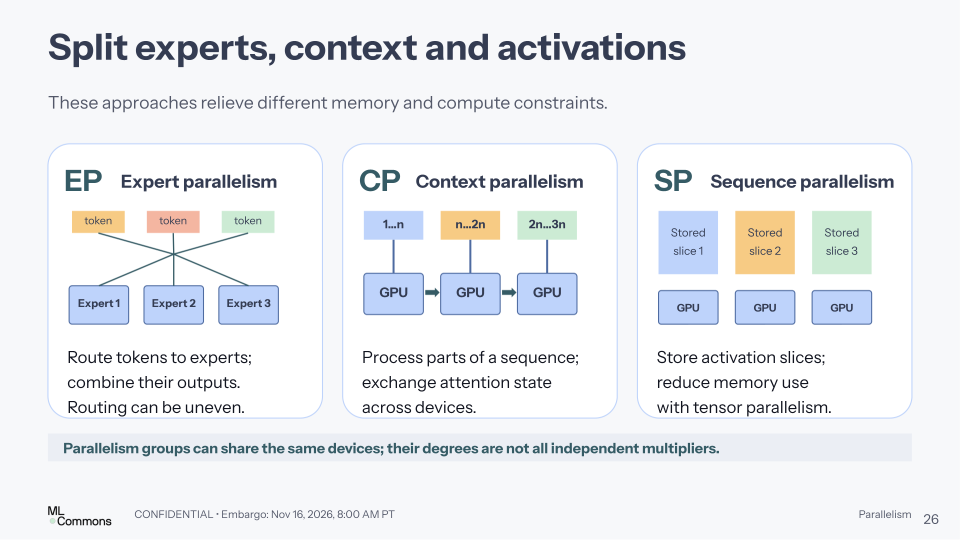
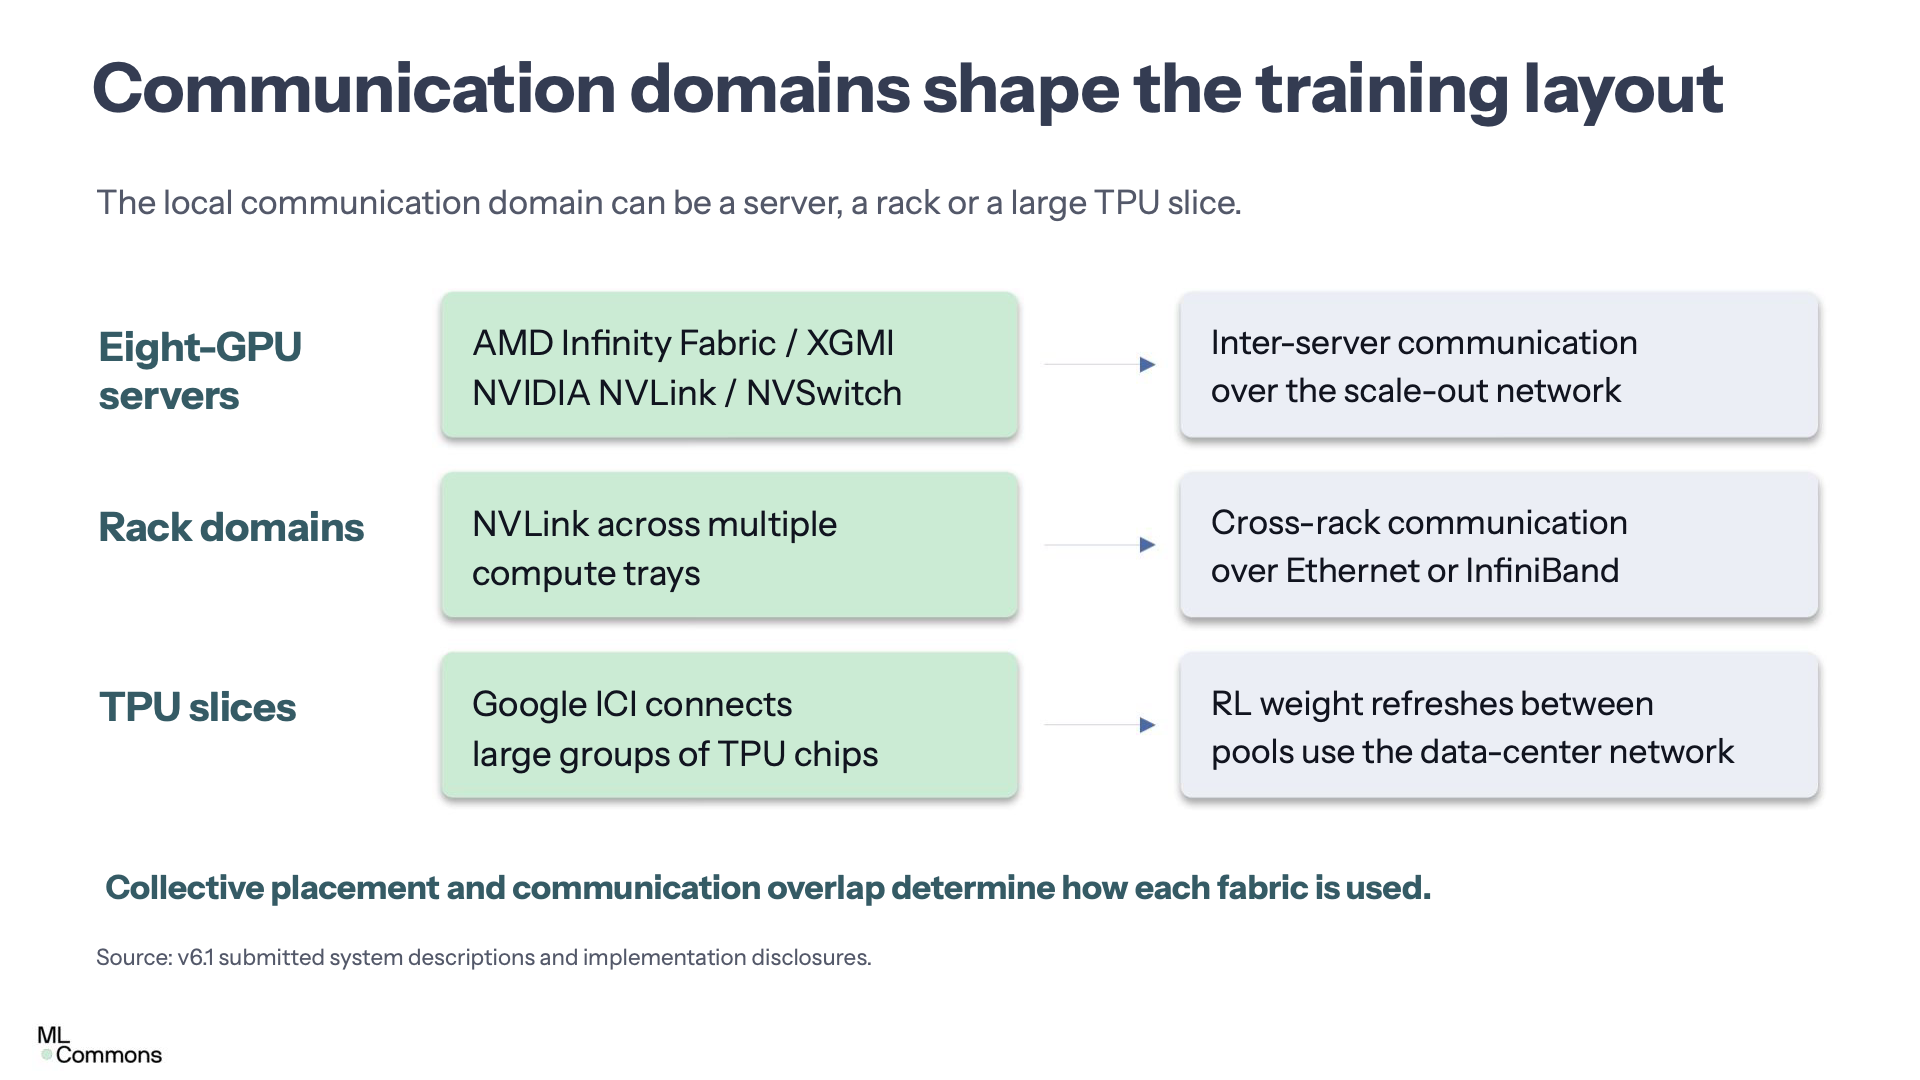
多节点系统成为常态
76%的系统采用多节点,最大规模达10240 GPU。节点设计向机架级演进,4加速器节点与8加速器服务器并存。
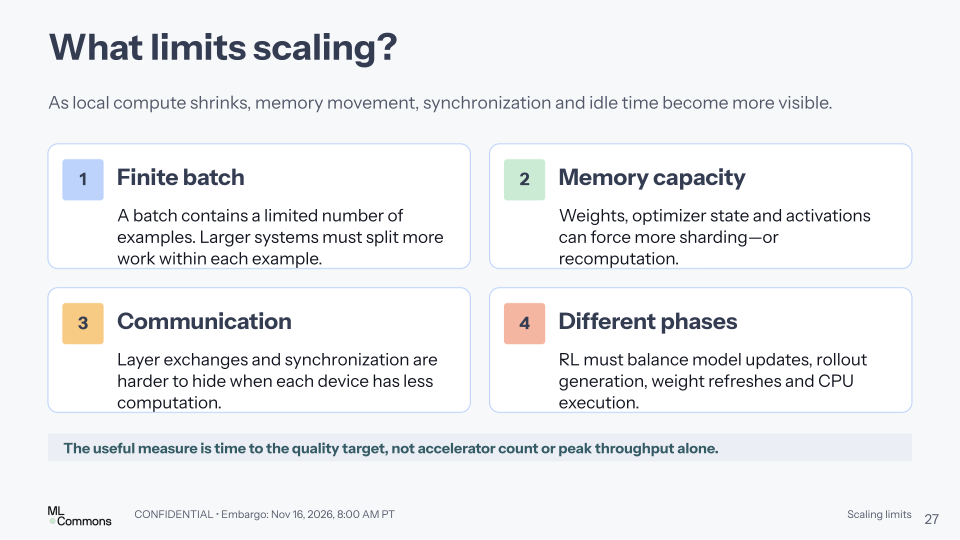
加速器分布
NVIDIA产品占据122个系统,AMD与Google TPU7x分别贡献27与4个系统,硬件多样性持续扩大。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接