
2026年9月9日,Cloudflare通知SGLang团队,其在Workers AI上部署的GLM-5.3存在跨请求KV cache暴露问题。团队迅速与Cloudflare及安全研究员协作,修复了请求拒绝路径,并加强了分离式服务中的缓存生命周期管理。
影响范围与受影响部署
该事件仅影响2026年8月27日至9月9日期间的@cf/zai-org/glm-5.3模型。Cloudflare调查确认,其他Workers AI模型未受波及。问题出现在分离式prefill/decode服务中,请求超出prefill KV cache容量时可能返回其他用户会话内容。
问题根源
Cloudflare配置的上下文长度为1,048,576 tokens,但prefill KV cache池仅能容纳681,280 tokens,导致拒绝路径被触发。在分离式路径中,被标记拒绝的请求仍可能进入handoff,decode端读取未初始化的缓存页。
即时修复与上游变更
Cloudflare于9月9日关闭模型公开访问,扩大prefill池容量,并部署引擎补丁。上游PR #36988和#38935分别实现了中止请求的及时回收,以及在进入分离式handoff前提前拒绝请求。
相关KV cache生命周期问题
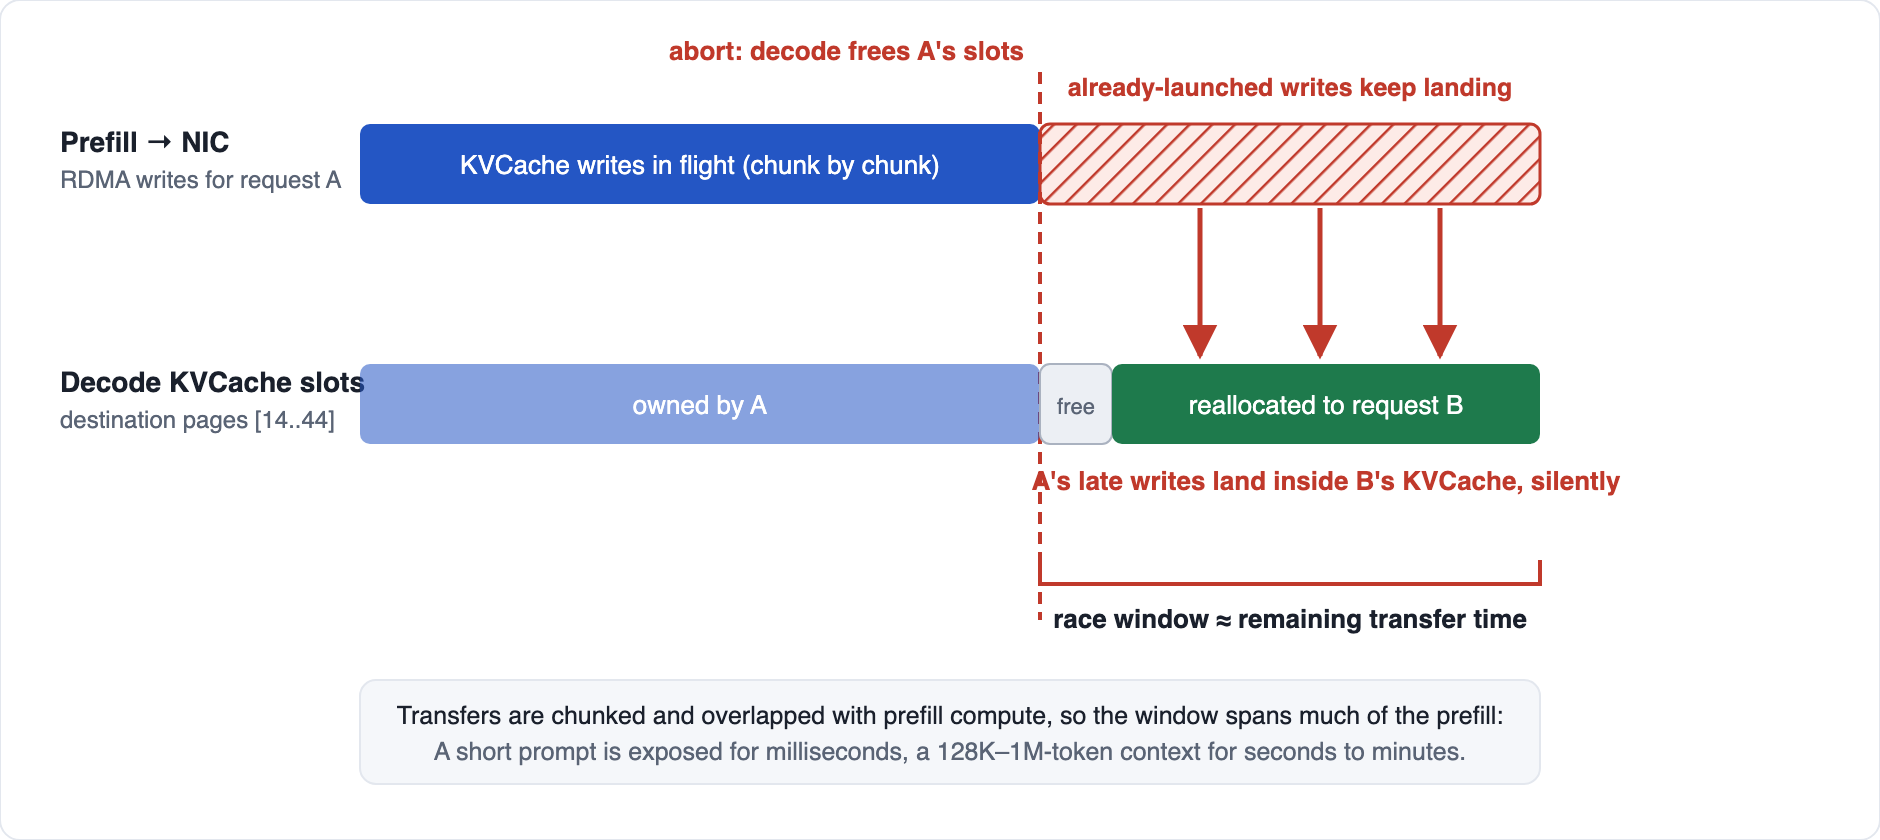
团队进一步解决了异步传输中的竞态条件。prefill/decode分离服务中,中止请求的RDMA写操作仍在进行,若decode提前释放槽位,可能导致写入覆盖其他请求的缓存。
背景与机制分析
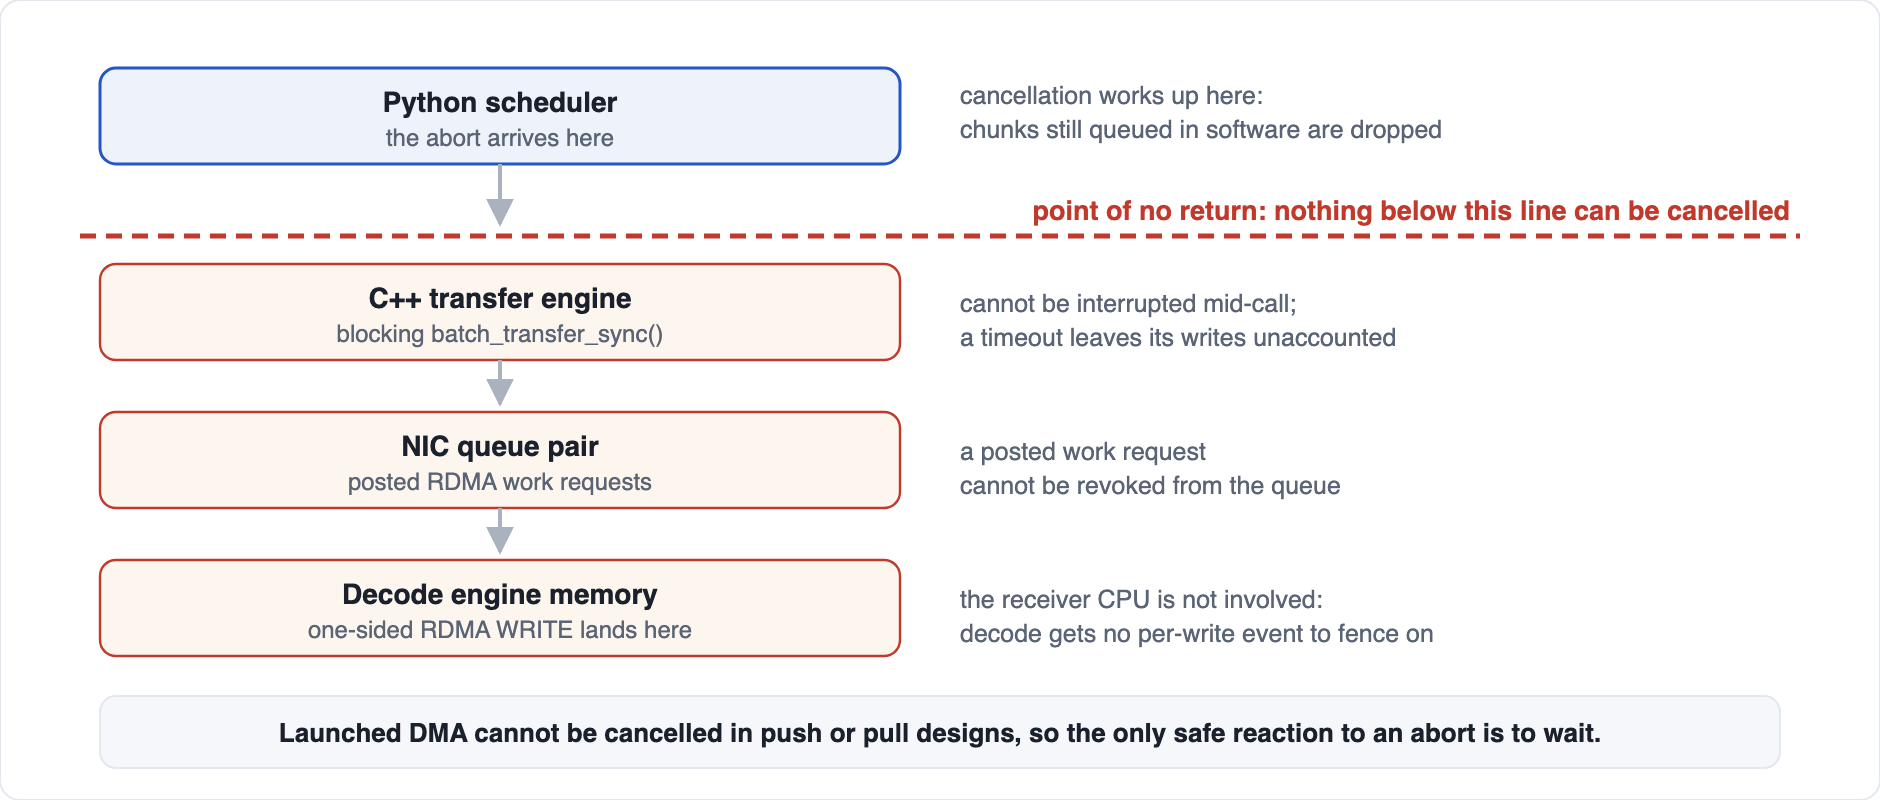
异步RDMA传输无法取消已发布的写操作,分配器可能在写操作完成前标记槽位为free,导致分布式use-after-free。完整活性处理需从路由器延伸至引擎层。
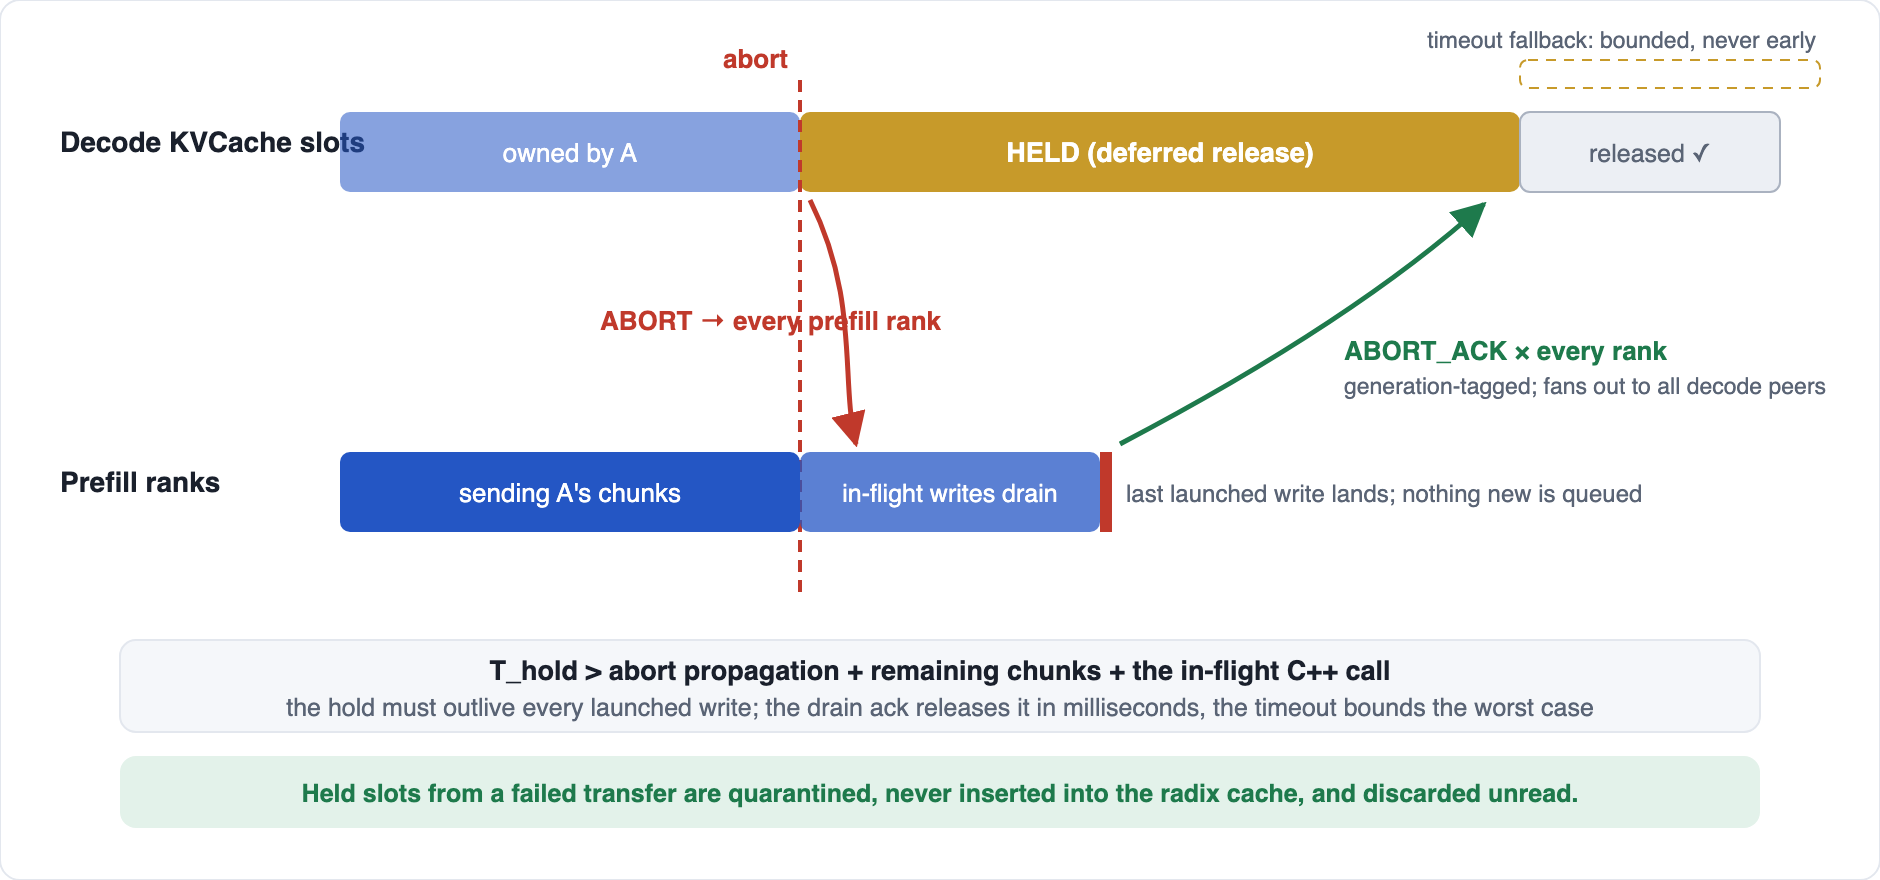
新机制引入延迟释放:decode端保留槽位直至所有确认或超时到期,配合传输层防护与完整性检查,有效消除静默数据污染风险。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接