
编者按:Palantir正把它的数据平台从情报机构一路推进到医院的排班室。但当算法开始决定谁在什么时间照看哪位病人,最先感受到摩擦的,往往不是签下合同的高管,而是轮班表上的一线护士。
从情报室到护士站
据WIRED报道,一家大型医院集团和一家放射影像网络为了理顺长期混乱的排班流程,选择了Palantir。承诺听上去很有说服力:把散落在多个系统中的排班表、人员资质、科室需求和患者预约数据打通,由算法给出更优的人力配置方案。
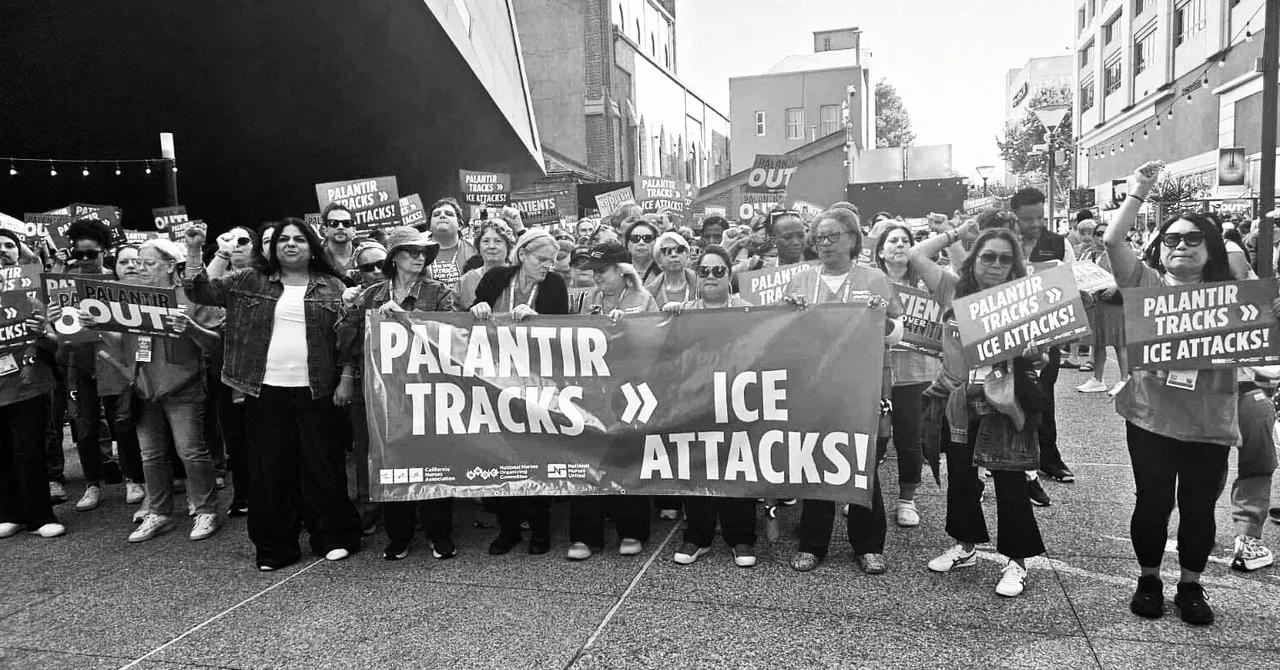
但现实走向了另一个方向。护士和其他一线员工表示,新软件并没有让工作变轻松,反而带来了排班错误、职业倦怠和持续的挫败感。本该被自动化消除的琐碎工作,只是换了一种形式重新压回到他们身上。
Palantir的医疗野心
Palantir以替情报与国防机构整合海量数据起家,近些年把医疗健康列为重点扩张方向。它向医院推销的核心叙事并不复杂:医疗系统真正的痛点不是缺少数据,而是数据被锁在互不相通的系统里;只要把这些孤岛连接起来,再叠加AI能力,运营决策就能从经验驱动转向数据驱动。
排班恰好是这套叙事最有说服力的试验场。护理人力通常是医院最大的一项支出,排班效率的微小改善,乘以数千名员工的规模,就能变成可观的成本节约。对供应商而言,这是最容易向董事会展示回报的场景;对医院管理层而言,这似乎是低风险的自动化起点。
排班为什么远比想象中困难
护士排班表面上是“把名字填进格子”,实际上是一个约束条件极其密集的优化问题:执业执照与专科资质、资历与轮转公平、工会协议与法定休息时间、护患配比、夜班与周末的分配、临时请假与病假替补……每一条规则背后,都对应着真实的临床安全底线。
算法理论上擅长处理这类高维约束,但前提是规则被完整、准确地写进系统,历史数据足够干净,例外情况有清晰的兜底流程。而多数医院恰恰在这三点上都不合格:规则大量存在于资深护士长的经验里,历史排班表充满临时妥协,例外情况每天都在发生。
当效率提升变成负担转移
报道中一线员工的抱怨指向同一个模式:软件给出的排班看起来合理,落到具体的人和病人身上却频繁出错——资质不匹配的护士被排进特定科室,强制休息时间被无意违反,临时变更的通知来得太晚,导致员工不得不手动核对、打电话协调、临时顶班补救。
结果是,医院在仪表盘上省下的行政时间,被一线以数倍的隐性劳动偿还。更隐蔽的代价是信任:当员工发现系统给出的安排“不能直接信”,他们就会自发建立一套复核流程——这套流程不会出现在任何项目验收报告里,却会真实地消耗人的精力与耐心。
AI落地医疗的结构性盲区
这类摩擦并非Palantir独有。过去几年,医疗AI的落地普遍呈现“前台是模型,后台是人”的格局:系统在演示环境里表现良好,一旦进入真实的病房和轮班体系,异常处理能力就显出不足。而护士群体长期以来就是医疗系统默认的兜底机制——设备出问题找护士,流程卡住找护士,软件出错也找护士。
问题在于,这类项目的成功指标通常由供应商与管理层共同定义:排班耗时缩短了多少、人力成本下降了几个百分点、系统上线了几个院区。而员工的认知负荷、患者安全的潜在风险、组织信任的流失,几乎不会出现在同一张验收清单上。
谁该为算法的失误负责
如果AI要真正进入临床运营,一线员工就不能只是系统上线后的使用者,而应当是共同设计者与验收者。排班这类高度依赖隐性知识的场景,尤其需要把护士长的经验作为系统输入,而不是当作需要被“优化掉”的旧流程。
更根本的问题是责任归属。当算法排错了班、患者在错误的时段得不到合适的护理,责任链条会从供应商滑向医院,再滑向当班护士。技术在组织中的位置越核心,这种责任错配造成的伤害就越大。
Palantir的医疗扩张仍将继续,效率叙事也不会消失。但这篇报道提供了一个必要的提醒:衡量一个医疗AI项目是否成功,不该只看它替管理层省下了什么,也要看它为一线制造了什么。如果答案是把错误清理工作悄悄转移给最忙碌的人,那么所谓自动化,不过是把成本藏得更深了一点。
本文编译自WIRED
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接