
推荐系统长期是MLPerf Training的重要组成部分。过去的DLRM benchmark主要衡量一个系统将个性化推荐模型训练到指定质量目标所需的时间。当前版本DLRMv2面向电商、流媒体等场景,通过用户行为和物品特征建模,利用深度学习捕捉二者之间的交互,从而生成更相关的推荐结果。
但随着序列建模和LLMs相关技术的发展,超大规模生产推荐系统正在发生架构迁移:它们不再把用户行为压缩为少量聚合后的dense features,而是将用户近期交互历史表示为逐事件的token sequence。此类模型在算力和参数规模增长时仍能持续提升,而早期基于feature interaction的设计往往会进入收益平台期。
MLPerf此前已经在inference套件中引入了基于HSTU的推荐基准,但training套件尚缺少对应工作负载。DLRMv4正是为了填补这一空白:它用HSTU替代传统feature-interaction stack,并引入新的Yambda-5B数据集,将真实多行为音乐交互数据扩展到生产级约560GB embedding footprint。
从DLRMv2到DLRMv4:为什么要换架构
DLRMv4的目标,是让MLPerf Training更准确地反映当下生产级DLRM workload的变化。一方面,模型需要在更长的用户历史上执行attention,计算复杂度显著提高;另一方面,约560GB规模的embedding table也要求在多张现代加速器之间进行sharding。这使得DLRMv4不仅是模型结构更新,也是对系统训练能力的新压力测试。
模型架构:HSTU取代传统特征交互栈
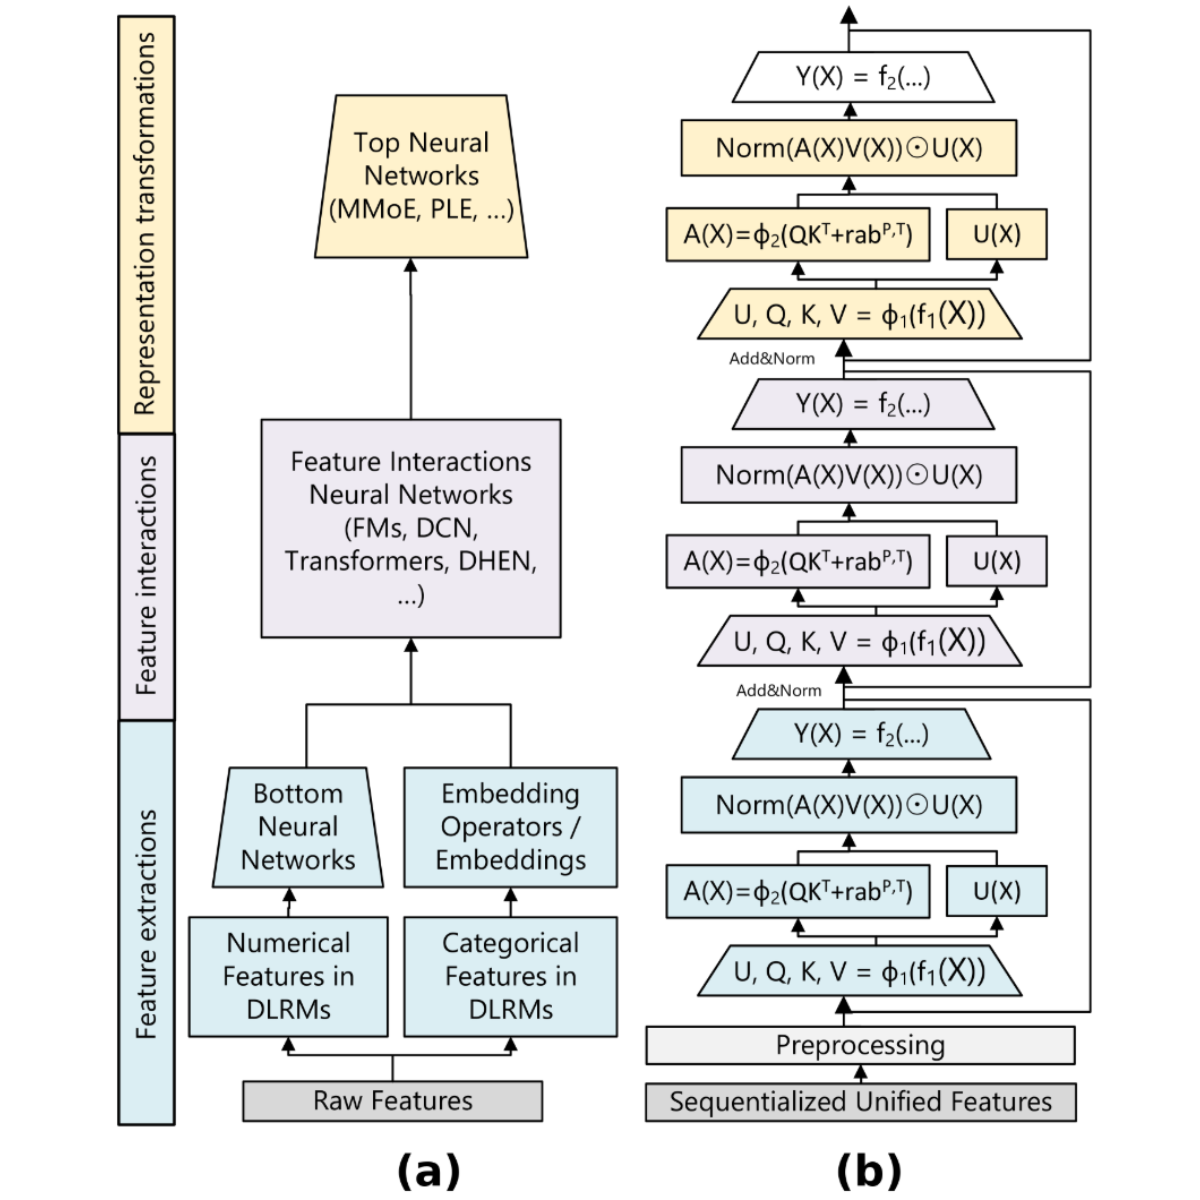
图1:传统DLRM架构(a)与HSTU架构(b)的对比。
传统DLRMv2代表的是一种“先编码、再交互”的生产推荐范式。输入数据形态各异,数值特征由bottom MLP处理,类别ID通过embedding lookup转换为向量。随后,这些表示被送入专门的feature-interaction模块,例如cross network、factorization machine或类似结构,最后由task head输出预测结果。
这种设计的核心建模能力集中在interaction模块,但它无法直接看到原始行为流。模型处理的通常是人工设计并预聚合后的输入,例如带衰减的计数器、比例特征以及池化后的embedding。
HSTU则取消了这种分工。它首先将异构特征空间序列化为统一的时间序列:类别特征和缓慢变化的上下文特征被并入用户按时间排序的物品与动作历史中,然后由一组相同的transduction layers端到端处理。
在每个HSTU layer内部,原本被DLRM拆分的三个阶段被折叠到同一个模块中:单次projection生成该层所需的内部表示;pointwise attention根据两个事件在位置和时间上的距离引入bias并聚合序列信息;gated transformation则让attention聚合后的特征直接交互,承担传统cross network和feed-forward block的角色。
这种设计让模型的主要扩展维度收敛为三项:depth、width和sequence length。HSTU相关工作表明,在算力与质量之间,它能够在跨越三个数量级的规模范围内保持power-law关系;相比之下,传统encode-then-interaction baseline在相同区间更容易趋于饱和。
一个训练样本如何被HSTU处理
以内容平台上为某位用户打分一个候选item为例:系统会先把该用户的历史交互整理为按时间交错排列的item与action流,行为类型可包括真实收听、显式喜欢、跳过等多种信号,并截断到数千个事件的固定预算内。
每个事件都会变成一个token,携带“用户看过或听过什么”“用户做了什么动作”“事件发生在何时”等信息。因此,像skip这样的负反馈不会被平均到某个计数器里,而是作为一等事件保留在序列中。
缓慢变化的上下文,例如用户身份和预计算cross features,会被压缩为少量prefix tokens放在同一序列开头;待评分的candidate item则被追加到序列末尾。这样,模型可以在单次前向过程中将候选内容与完整历史进行比较,而不需要额外的target-aware pooling步骤。
最终,HSTU stack处理这一整条因果序列,candidate位置的表示被送入一个小型head,输出engagement prediction。把历史、上下文与候选目标放在同一个causal block中联合建模,是HSTU更贴近生产推荐系统、同时也更考验系统训练能力的关键。这一配置也与MLPerf DLRMv3 inference benchmark的模型类别保持一致。
数据集:Yambda-5B带来真实多行为时间线
DLRMv4使用Yambda-5B进行训练。Yambda-5B由Yandex Music公开发布,是目前规模最大的开放式、包含真实用户多行为交互的推荐数据集之一。基准采用完整的5B-event版本。
| 属性 | 数值 |
|---|---|
| Source | Yandex Music public release |
| Interactions | 约4.79B |
| Users | 1M |
| Items | 9.39M |
| Behavior types | 5类:listen、like、dislike、unlike、undislike |
| Raw size | 约38GB(Yambda-5B variant) |
| Per-event bytes | 约20字节 |
表1:Yambda-5B数据集核心属性。
相比DLRMv2使用的Criteo 1TB数据集,Yambda更适合HSTU式模型。原因在于,HSTU需要真实的per-user timeline:每次交互都记录用户、物品、动作类型和时间,因而可以按时间顺序重建每个用户的行为历史,并以序列形式输入transducer。约4.79B条交互也足以让完整训练运行保持持续负载。
| 指标 | Criteo 1TB(DLRMv2) | Yambda-5B(DLRMv4) |
|---|---|---|
| Real data | Yes | Yes |
| Interaction volume | 4.2B rows | 4.79B rows |
| Per-user history | No,仅flat features | Yes,multi-behavior pools |
| On-disk size(raw data) | 约4TB(denormalized) | 约38GB(normalized) |
| Embedding Table Size | 约100GB | 约560GB(加入cross-feature tables后) |
| HSTU-aligned | No,无sequence axis | Yes |
表2:Yambda-5B与Criteo 1TB(DLRMv2)对比。
特征扩展:embedding table扩大到约560GB
原始Yambda包含四类native sparse features:item、artist、album和uid。DLRMv4进一步加入cross-product hashed tables。Cross features是工业推荐系统中的常见做法,通过显式表示诸如user × artist、item × hour-of-day等特征组合,提升排序质量。近期研究也显示,分配给cross features的内存越多,其收益可能持续扩展。
引入这些特征后,DLRMv4更接近真实生产模型,同时在512维embedding和fp32精度下,将embedding table规模推至约560GiB。
| Table | Category | Cardinality | Size(512 embedding dimension,fp32) |
|---|---|---|---|
| item | native | 9.39M | 19.2GB |
| artist | native | 1.29M | 2.6GB |
| album | native | 3.37M | 6.9GB |
| uid | native | 1M | 2.0GB |
| user × artist | cross feature | 100M | 204.8GB |
| user × album | cross feature | 40M | 81.9GB |
| user × hour | cross feature | 24M | 49.2GB |
| item × hour | cross feature | 40M | 81.9GB |
| artist × hour | cross feature | 32M | 65.5GB |
| user × is_organic | cross feature | 2M | 4.1GB |
| user × artist × hour | cross feature | 40M | 81.9GB |
| Total | 约560GB |
表3:通过cross-product feature tables对Yambda-5B进行特征扩展。
为什么数据分布也很关键
真实推荐流量通常高度倾斜:少数热门item会贡献大量交互,而长尾内容则占据庞大的物品集合。一个推荐基准如果要代表生产系统,就必须具备类似的数据分布特征。原文指出,MLCommons对Yambda-5B进行了分析,以确认其是否符合这种真实推荐场景中的skewed traffic特征。
总体来看,DLRMv4的意义不只是替换一个模型或数据集。它把MLPerf Training中的推荐负载,从传统的特征工程与显式交互模块,推进到面向长用户历史、序列化行为建模和超大embedding sharding的新阶段。对于训练系统而言,这意味着同时面对更复杂的attention计算、更大的embedding footprint,以及更接近超大规模生产推荐系统的数据形态。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接