
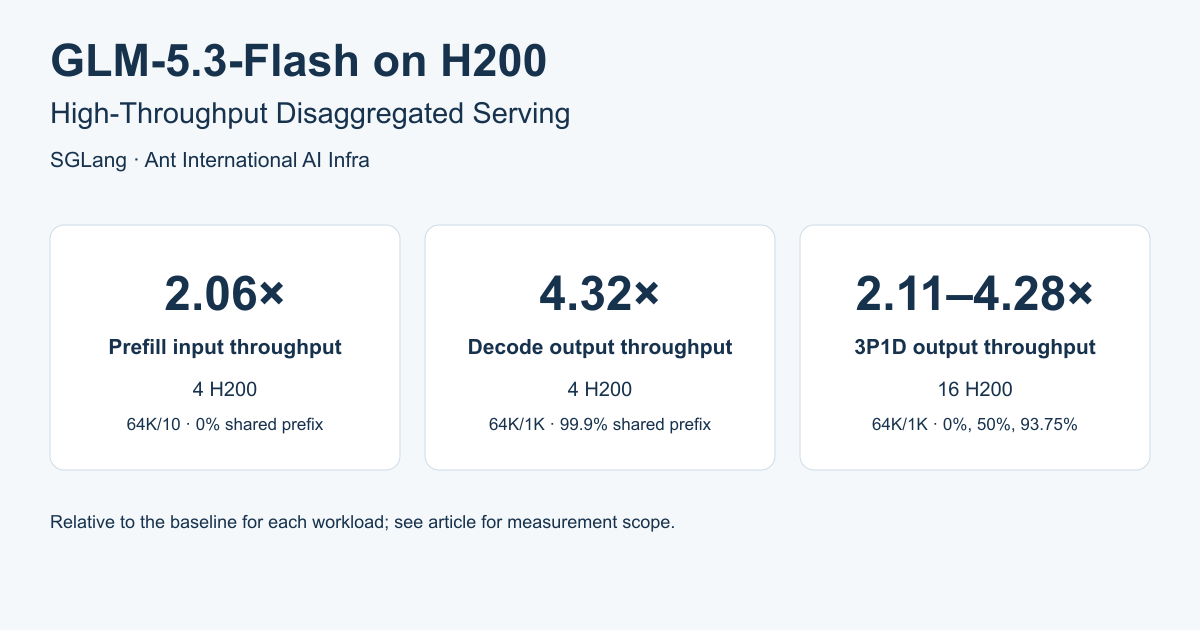
GLM-5.3-Flash结合稀疏注意力、循环线性注意力和MoE架构。在长上下文场景下高效服务需满足高并发内存、低输出token成本及充足prefill吞吐。Ant International AI Infra团队通过SGLang在H200上采用混合缓存复用、快速投机执行、内核调优和FP8通信,取得显著成果。
1. 架构与工作负载
模型具备两种注意力状态表示:稀疏注意力存储历史KV,线性注意力维护循环状态。PD分离允许各自配置并行度和后端,四卡H200实例间通过NIXL传输缓存。
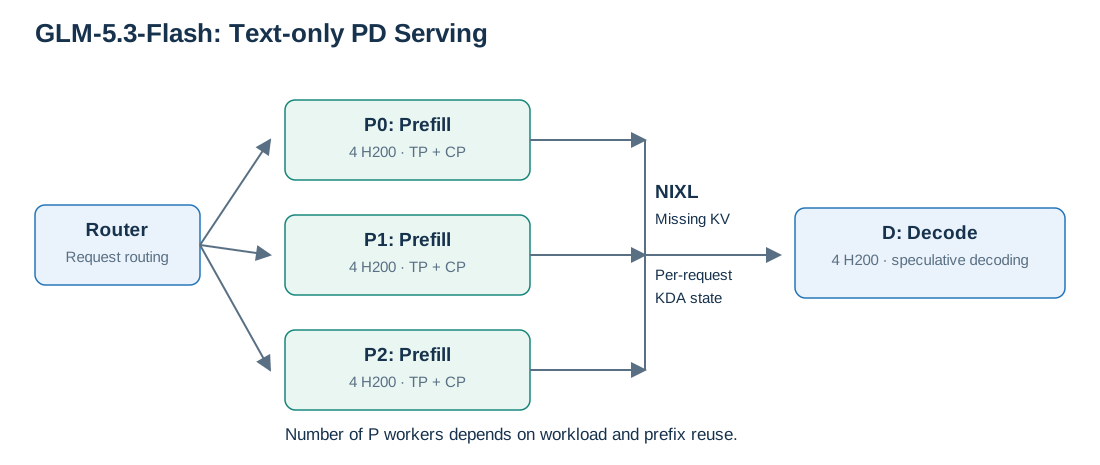
测试使用64K输入/10-token输出无共享前缀测量prefill,64K/1K 99.9%共享前缀测量decode容量。
2. 将缓存容量转化为并发
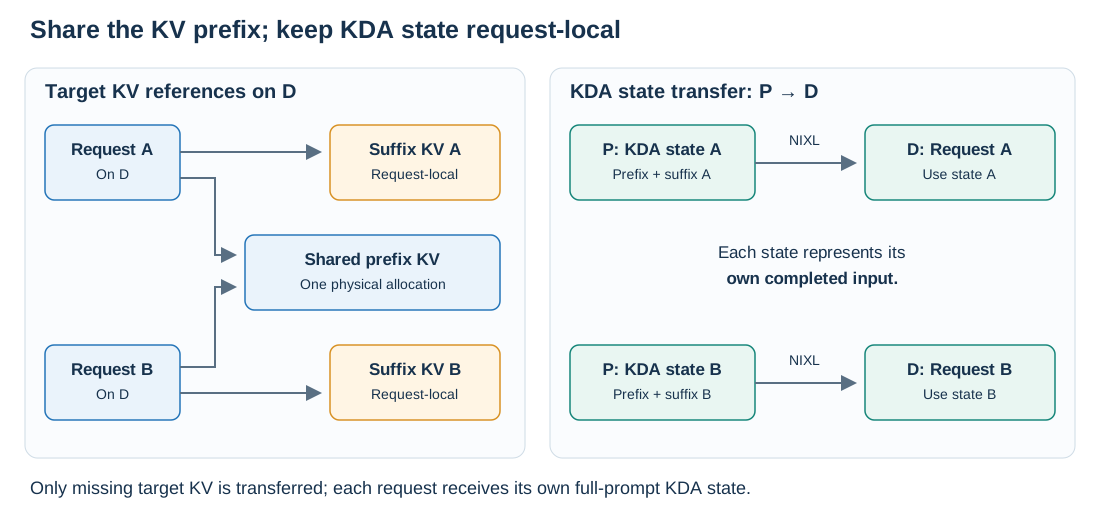
通过FP8 KV与BF16循环状态重平衡池大小,采用ReplaySSM管理投机状态。KV-only RadixCache实现跨请求前缀KV共享,同时为每个请求保留独立循环状态。
3. 降低有用输出成本
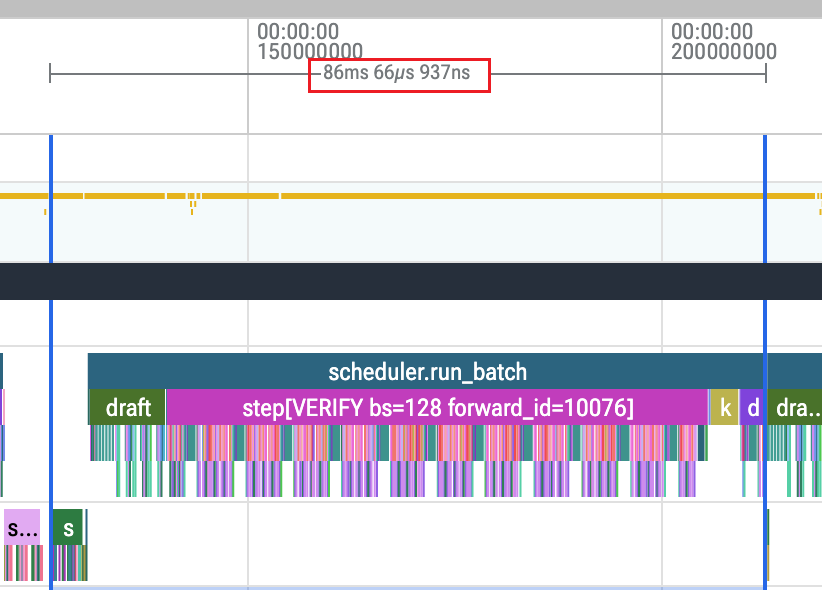
对比MTP718与DFlash2 block8,后者单次前向生成block,周期时间从86.94ms降至74.14ms,输出吞吐提升8.4%。
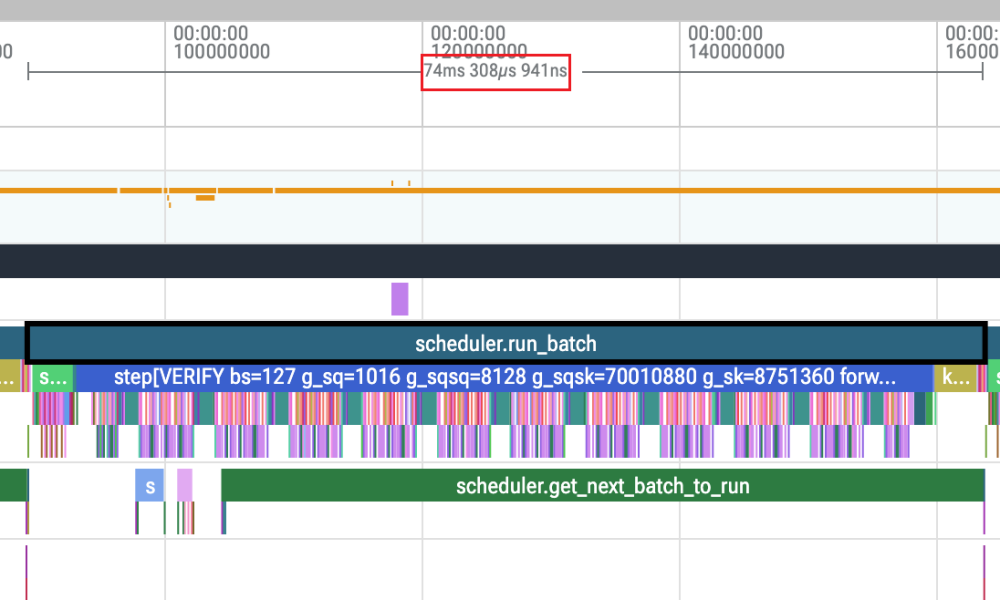
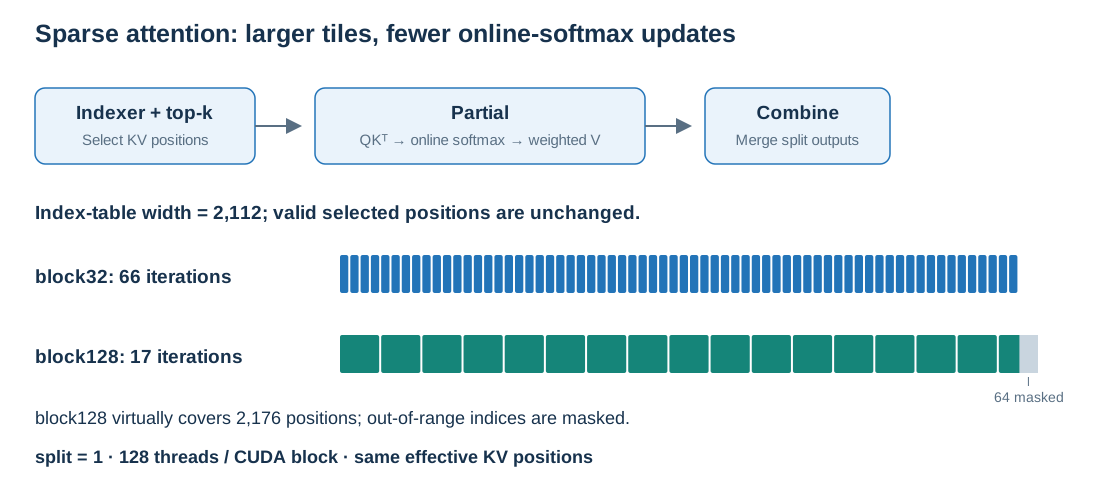
针对真实路由调优MoE GEMM,M1024配置下吞吐再提升3.12%。DSA Partial采用更大KV tile(128),减少迭代次数。
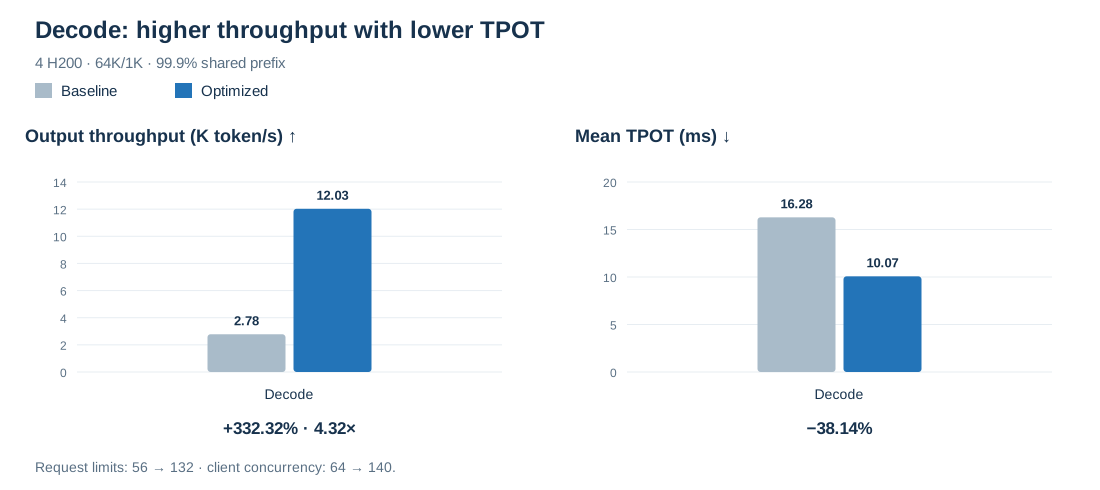
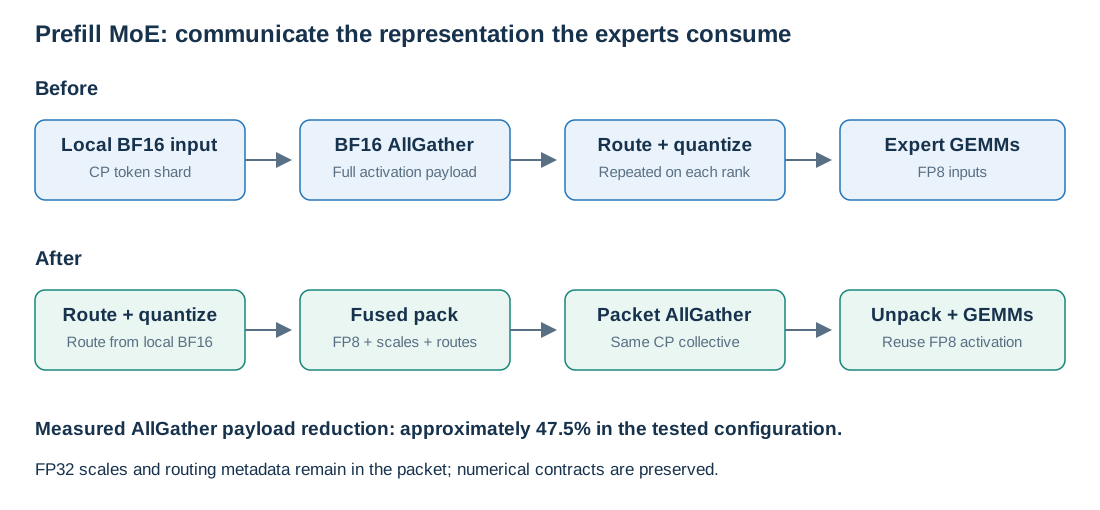
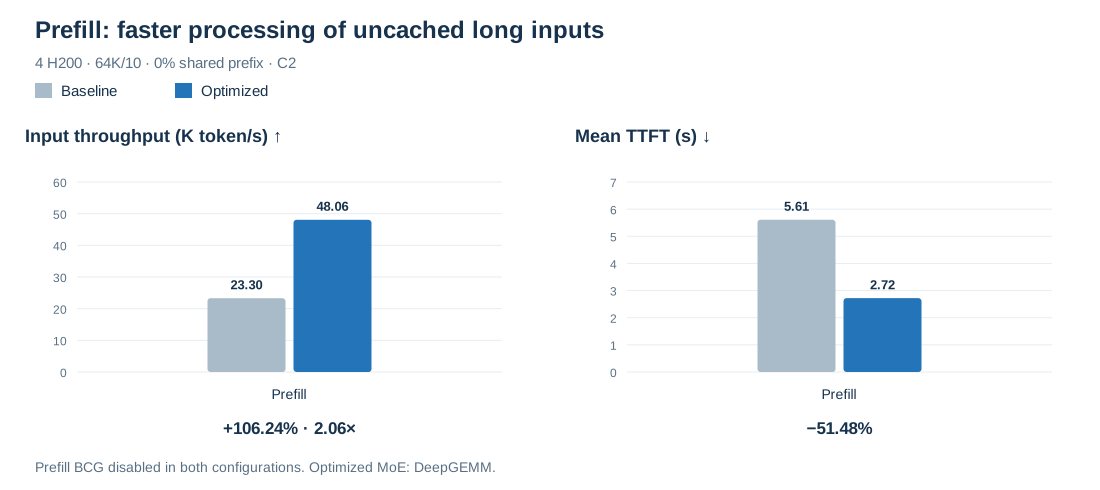
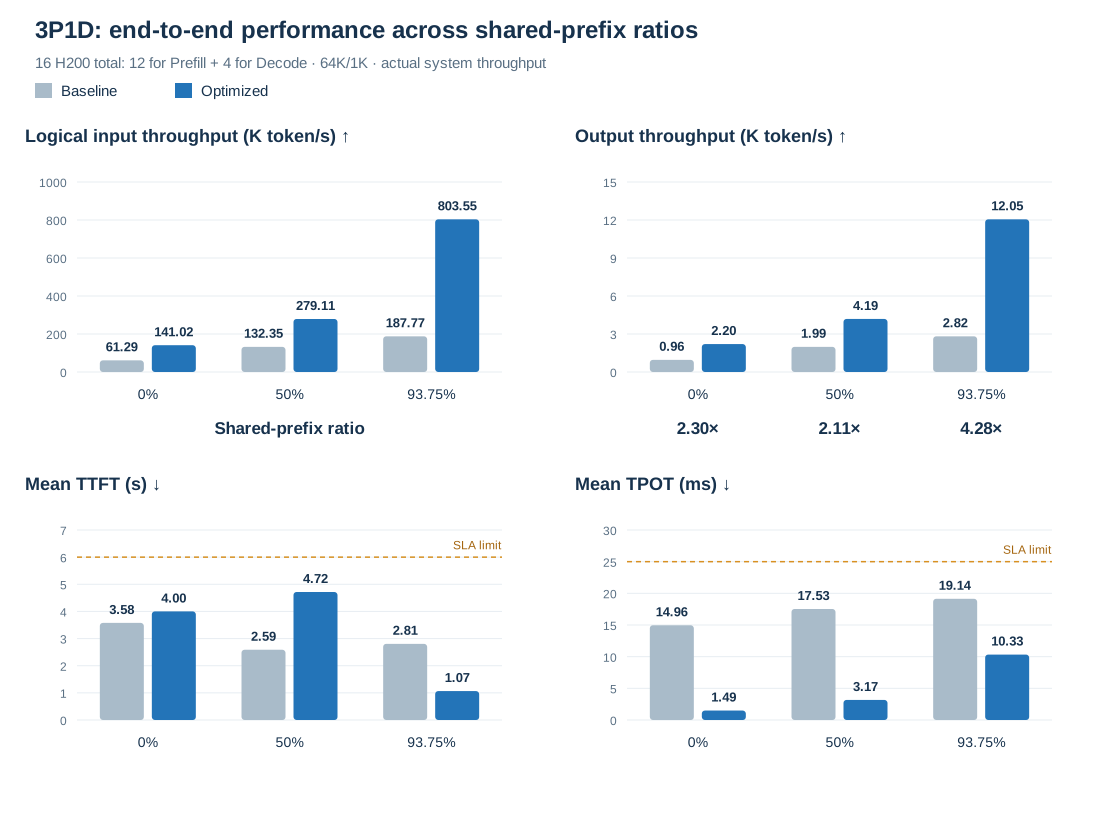
最终在四卡H200上实现prefill输入吞吐48064 tokens/s,decode输出吞吐12027 tokens/s,3P1D端到端吞吐提升显著。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接